SQLiteの使い方|架空の制作案件で登録・結合・更新の取り消しを練習する
※本記事にはPRを含む場合があります。
こんにちは。『脱会社員』脱サラを応援し続けるブログ、運営者の『なかびー』です。
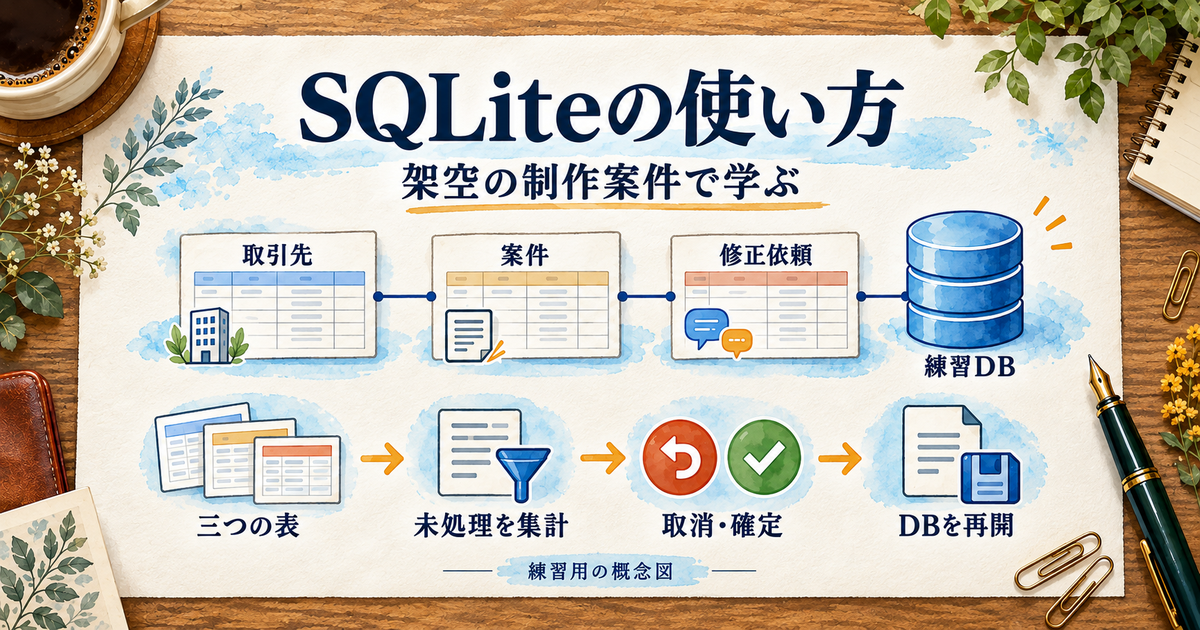
SQLiteの使い方を覚えるなら、小さなデータベースを一つ作り、登録した内容を取り出し、変更してから開き直すところまで進めると、SQLと保存の関係がつかめます。この記事では、架空の制作案件を使って「どの案件に未処理の修正が残っているか」を調べます。
扱うのは取引先3件、案件4件、修正依頼6件です。最初の未処理は3件・75分。依頼のうち1件だけを完了にすると、2件・50分へ変わります。途中で条件を付け忘れた更新も、隔離した練習用DBの中で試し、確定前に取り消します。数値を見ながら、表の関連付けと変更の範囲を確認しましょう。
説明は2026年10月14日(日本時間)に確認したSQLite公式資料に基づきます。掲載するSQLのデータ処理はPython標準のSQLiteで検算していますが、Windows上のsqlite3 CLI、CLIからのCSV出力、.backupの一連の操作は実機試験していません。CLI部分は公式資料に基づく手順で、掲載図は操作の考え方を示す説明図です。実在する顧客情報や業務中のDBは使いません。
練習のゴールは、SQLを実行できることに加え、「いま開いているファイル」「一行の意味」「変更対象」「確定して残った状態」を自分で確かめられることです。Pythonの知識は前提にしません。
SQLiteを開き、練習用データベースの場所を確かめる
SQLite、入力用のCLI、DBファイルを分けて考える
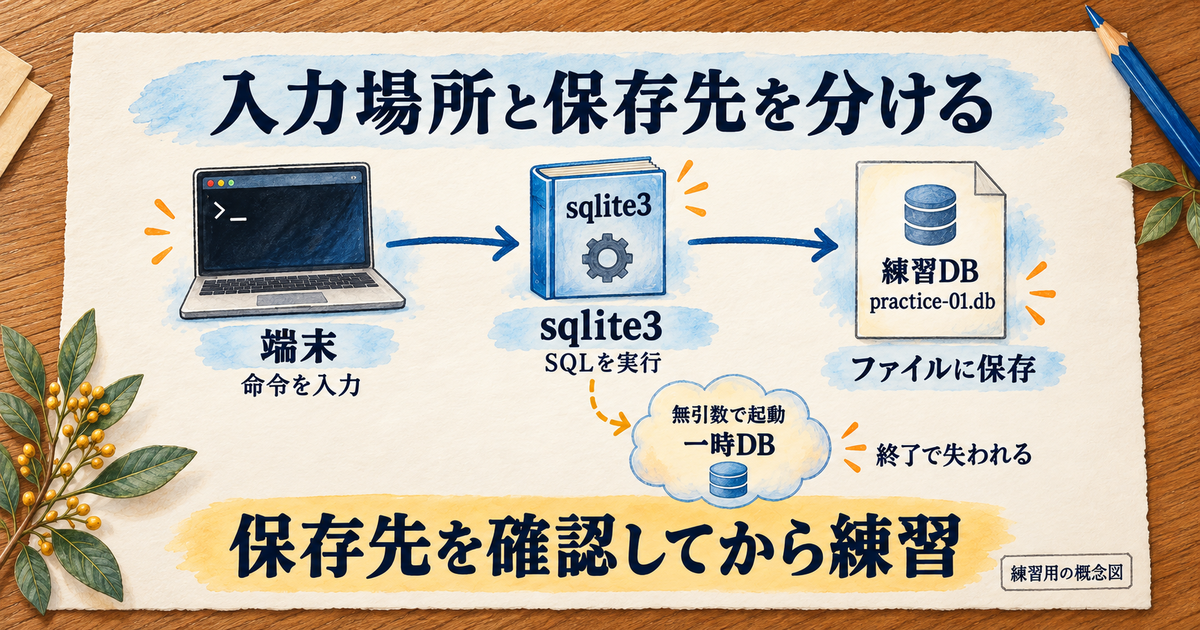
SQLiteは、SQLでデータを読み書きするためのデータベースエンジンです。今回文字を入力するsqlite3は、そのエンジンを使うコマンドラインの道具です。そして、取引先や案件の情報を残す入れ物がDBファイルです。この三つを分けておくと、「画面を閉じたら消えるのか」「どのファイルを開けば続きができるのか」を考えやすくなります。
表計算ソフトの画面へ直接入力する感覚とは少し異なります。SQLは、行を追加する、条件に合う行を取り出す、指定した値を変える、といった要求を文字で伝えます。処理後に表が常に画面へ出るとは限りません。何も表示されなかった場合も、後続のSELECTで状態を調べるまでを一つの操作として進めます。
この記事はWindowsで公式のsqlite3.exeを使う経路を中心に説明します。未導入ならSQLite公式のダウンロードページでWindows向けのtools配布物と、自分のPCのCPUに適合するものを確認します。ライブラリ用のDLLだけでは、ここで使う入力画面になりません。ZIPを展開してsqlite3.exeを確認してください。会社管理のPCなどで実行制限がある場合は管理方針に従い、警告を無効化して進めないでください。
配布物の番号や画面のプロンプトは版によって変わります。本稿では特定のZIP名を固定しません。すでに導入済みなら、そのsqlite3を使う前に入手元と版を確認します。複数の実行ファイルがある環境では、どれを起動したかも練習メモへ残すと、別の端末で表示が違ったときの手掛かりになります。
新しい練習フォルダーと未使用のDB名を用意する
まずエクスプローラーで、この実習だけに使う新しいフォルダーを作ります。保存場所のフルパスを確認し、その中にpractice-01.dbというファイルがまだ存在しないことを確かめてください。ここで決めたフルパスは最終章の再開にも使います。同じ名前のファイルを別の場所に作ると、どちらへ登録したか分かりにくくなるためです。
sqlite3.exeをダブルクリックして起動した場合など、DB名を指定せずに開くと、一時的なデータベースから始まることがあります。文字を入力できる画面になったことと、保存したいファイルへ接続できたことは別に確認します。そこで、次の.openを使って対象を明示します。
以下の「実際の練習フォルダーのフルパス」は説明用の文字です。自分で確認したパスに置き換えてから入力してください。Windowsでもこの例では区切りを半角のスラッシュにそろえ、空白があるパスを一つの引数として扱えるよう引用符で囲みます。置換後のフォルダーが存在することも必要です。
.open "実際の練習フォルダーのフルパス/practice-01.db".openの実行結果にエラーがないことを読み、次の命令で接続先を調べます。mainの対象が、先ほど選んだフルパスになっているかを見ます。似た名前の別DBなら、この先の表作成を始めず、保存先を見直してください。
.databasesSQLとドットで始まる命令を混ぜない
SQLの文末には半角のセミコロンを付けます。一方、.openや.databasesはsqlite3 CLI自身への命令です。左端のドットから一行で入力し、この実習ではセミコロンを付けません。SQLの続きが求められている途中に、ドット命令を追加しないようにします。入力途中なのか、次の命令を受け付ける状態なのかを画面で確かめてください。
例えばSELECT文の途中で引用符を閉じ忘れると、改行しても入力が続くことがあります。そこへ別の命令を貼ると、意図しない長い文になり、原因を探しにくくなります。見た目を合わせるためにセミコロンを何度も足すより、入力中の文とエラーを読み、正常な入力待ちに戻ってから次へ進む方が確実です。CLIの操作規則は公式のコマンドライン解説で確認できます。
次に、案件のない修正依頼を登録しないための外部キー検査を有効にします。これは接続ごとの設定なので、最初の起動時だけでなく.openでDBを開き直したときにも必要です。後で使うBEGINより前、トランザクションの外で一文ずつ実行します。
PRAGMA foreign_keys = ON;PRAGMA foreign_keys;読み戻した値が1なら有効です。0や結果なし、エラーなどで確認できなければ、登録へ進みません。有効化を書いたつもりでも、トランザクションの途中では切り替わらないため、実際の値を読むことが大切です。設定の範囲はSQLite公式の外部キー解説にも示されています。
.tables新しい実習DBなら、ここでは表がまだありません。表名が出たら既存のDBか、途中まで作成したDBを開いています。.schemaで構造を読むことはできますが、そのまま次章を全量実行しないでください。やり直す場合は既存ファイルを残し、存在しない別名practice-02.dbなどを確認して.openし直します。その後、保存先、外部キーの1、空の表一覧を再確認します。
この別名での再開始は、元ファイルを消して初期化する手順ではありません。未確定の変更があると分かる場合はROLLBACKの成功を確認してから切り替えます。状態が分からないままCOMMITして保存しようとはしません。以降の説明のpractice-01.dbは、やり直した場合には自分が採用した別名へ読み替えてください。
.headers on.mode box最後の二つは、列見出しと読みやすい枠付き表示を使うための設定です。表示を整える操作は、DBの中身の正しさを保証する検査ではありません。画面の装飾より、保存先を一つに決められたことをこの章の完了条件にしましょう。
取引先・案件・修正依頼を、IDでつながる三つの表へ登録する
先に一行の単位を決める
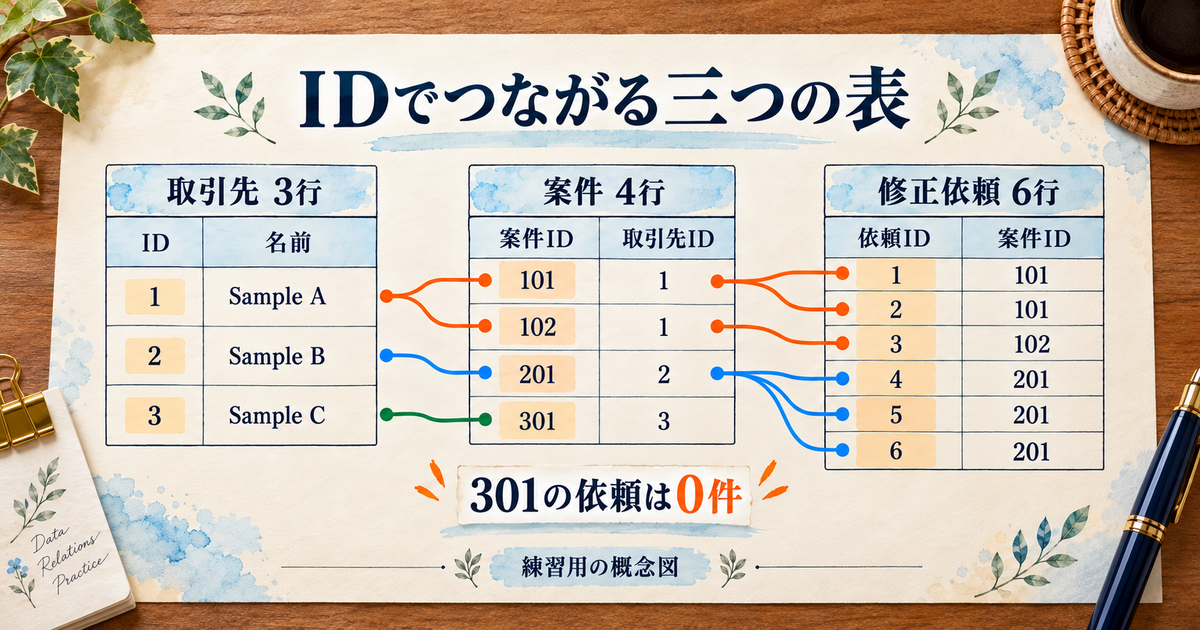
今回の題材は、制作を依頼する取引先、受けた案件、その案件に届いた修正依頼です。取引先のSample Aにはバナー制作と商品写真の2案件があります。バナー制作には2件の修正依頼が届いています。この関係を全部一枚の表へ書くこともできますが、取引先の名前や案件名を修正のたびに繰り返すと、どれが同じ対象なのかを管理しにくくなります。
そこでclientsは取引先一つにつき一行、jobsは案件一つにつき一行、requestsは修正依頼一つにつき一行とします。同じ取引先に案件が複数あっても、取引先の情報はclientsに置きます。案件側へclient_idを持たせ、その番号が同じであることによって結び付けます。修正依頼から案件へも、同じようにjob_idでつなぎます。
IDは表示上の行番号ではありません。後から一覧を並べ替えても、依頼6が依頼1へ変わることはありません。また、案件101と依頼1が先頭に表示されたから対応する、という結び方もしません。表ごとに何の番号なのかを示した上で、関係するIDを比較するのがこの教材の基本です。
架空の取引先ラベルや案件名は公開練習用です。自分の顧客名へ置き換える必要はありません。日付や見積分数も計算を確かめるための値で、納期の約束や実際の作業時間を表していません。内容を実務らしく増やす前に、少ない行を一つずつ説明できる状態を作ります。
構造を作り、入力を守る制約を付ける
外部キーの設定が1で、表が空であることを確認できたら、以下を上から一文ずつ実行します。最初に参照先のclients、次にjobs、最後にrequestsを作ります。一つのCREATE TABLEは複数行でも、末尾のセミコロンまでで一文です。エラーが出た場合はそこで止め、残りをまとめて貼り続けないでください。
CREATE TABLE clients (
  client_id INTEGER PRIMARY KEY,
  label TEXT NOT NULL UNIQUE
);
CREATE TABLE jobs (
job_id INTEGER PRIMARY KEY,
client_id INTEGER NOT NULL REFERENCES clients(client_id),
title TEXT NOT NULL,
due_on TEXT
);CREATE TABLE requests (
request_id INTEGER PRIMARY KEY,
job_id INTEGER NOT NULL REFERENCES jobs(job_id),
detail TEXT NOT NULL,
state TEXT NOT NULL CHECK (state IN ('open','done','cancelled')),
minutes INTEGER NOT NULL CHECK (typeof(minutes) = 'integer' AND minutes >= 0)
);INTEGER PRIMARY KEYは、今回の各行を特定する主キーです。同じ依頼IDを二つ登録できないため、後で依頼6だけを更新するときのよりどころになります。取引先ラベルのUNIQUEは同じラベルの重複を防ぎますが、案件名には同じ制約を付けていません。別の取引先で同名の案件があっても、job_idで区別できる設計だからです。
NOT NULLは値がNULLのまま入ることを禁止します。ただし、空文字や空白だけの文字列までこの指定一つで拒否するわけではありません。今回の制約がどこまで守るかを見極め、エラーにならなかった名前なら必ず適切だとは考えないでください。due_onにはNOT NULLを付けず、日付が未定の案件をNULLで保持します。
stateはopen、done、cancelledの三つに限定しました。完了をfinishと書いたり、大文字のOPENにしたりして別の状態が混ざるのをCHECKで防ぎます。minutesには整数かつ0以上という条件を付けています。SQLiteの通常の表では、型名を書けばあらゆる入力が厳格に検査されるわけではないため、ここでは保存される値のtypeofも条件にしています。
なお、数字らしい文字が型の規則で整数へ変換される場合があります。このCHECKはキー入力の形式をそのまま見張るものではありません。「元の入力が文字だったか」ではなく、「保存される分数が整数で負にならないか」を確認する設計です。型の扱いはSQLite公式のデータ型、制約の働きはCREATE TABLEの説明が参考になります。
親から子の順で13行を登録する
INSERT INTOは行を追加する命令です。この教材では、表を作ったときの列順に値を並べています。例えばjobsの最初の行は、案件IDが101、取引先IDが1、案件名がバナー制作、日付が2026-11-05です。数字の1が案件名の一部になっているわけではありません。列の定義を見ながら、一つの括弧が一行に対応することを確かめます。
INSERT INTO clients VALUES
  (1,'Sample A'),(2,'Sample B'),(3,'Sample C');
INSERT INTO jobs VALUES
(101,1,'バナー制作','2026-11-05'),
(102,1,'商品写真','2026-11-08'),
(201,2,'説明動画','2026-11-10'),
(301,3,'案内PDF',NULL);INSERT INTO requests VALUES
(1,101,'文字のコントラスト','open',30),
(2,101,'誤字の修正','done',10),
(3,102,'写真の切り抜き','open',20),
(4,201,'字幕の修正','done',45),
(5,201,'冒頭映像の差替え','cancelled',15),
(6,201,'音量の調整','open',25);clientsを先に入れるのは、jobsが参照する取引先を存在させるためです。requestsを最後にするのも同じ理由です。親がまだないのに子だけを追加しようとすると、外部キー検査が有効な接続では拒否されます。表を作る順番だけを守っても、参照先の行が未登録なら足りない点に注意しましょう。
次の問合せで取引先3、案件4、依頼6になっていることを確認します。合計13行でも、すべてが同じ種類の13件ではありません。修正依頼は6件です。以降「件数」と書くときには、どの表の何を数えたかを必ず付けて読みます。
SELECT
  (SELECT COUNT(*) FROM clients) AS clients_count,
  (SELECT COUNT(*) FROM jobs) AS jobs_count,
  (SELECT COUNT(*) FROM requests) AS requests_count;
SELECT request_id, job_id, detail, state, minutes
FROM requests ORDER BY request_id;件数が合っていても、番号や状態の写し違いは残り得ます。最後のSELECTで全列を表示し、登録例と対応させてください。全行を見るこの確認が、後のROLLBACKで元に戻ったかを比べる基準になります。作成・登録の途中で失敗した場合は、件数と.tables、.schemaからどこまで進んだかを見て止まり、最初の章の別名DBによる再開始へ戻れます。
四つの不正入力が拒否されることを確かめる
以下は正常な登録例とは分けた失敗実験です。今作った練習用DBだけで、一文ずつ実行します。最初は存在しない案件999、次はすでにある依頼ID1、その次は負の分数、最後は決めていない状態を入れようとします。先にどの条件で止まるかを考えてから実行すると、エラーが表の設計と結び付きます。
INSERT INTO requests VALUES (90,999,'親IDの検査','open',5);INSERT INTO requests VALUES (1,101,'重複IDの検査','open',5);INSERT INTO requests VALUES (91,101,'分数の検査','open',-1);INSERT INTO requests VALUES (92,101,'状態の検査','waiting',5);この四文では、想定した制約エラーを一つずつ読むことが目的です。四文すべてを一括で送って最後の表示だけを見る方法にはしません。想定と違うエラーや、拒否されず登録できてしまう結果なら先へ進まず、接続先、外部キー設定、実際の定義を確認します。最後に全列のSELECTを再実行し、依頼が元の6行のままであることを照合してください。
この例でエラーが一文の登録を止めたことを、「それ以前の操作まで全部取り消された」と読み替えないでください。すでに登録した13行は別に確認します。文単位で入力を防ぐ制約と、複数の操作をまとめて確定・取消するトランザクションは役割が違い、後者は第五章で扱います。
未処理の依頼と日付未定の案件を、条件付きで取り出す
必要な列と対象の条件を言葉で決める
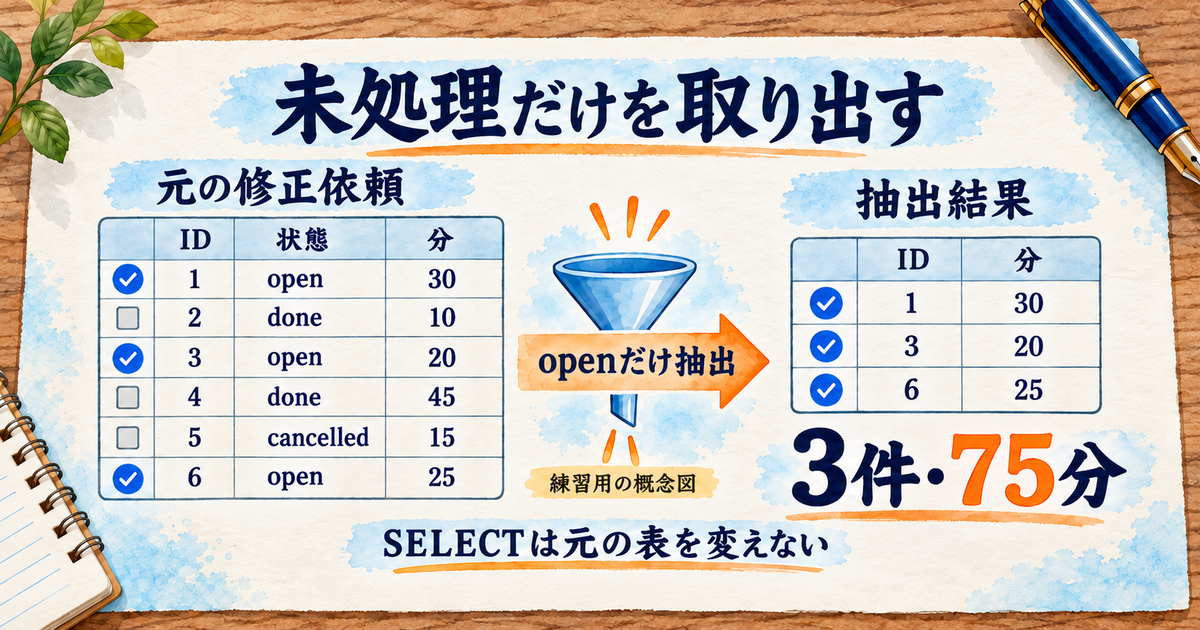
データを取り出す前に、何を知りたいかを一文にします。ここでは「未処理の修正依頼について、依頼番号、案件番号、内容、見積分数を確認したい」です。取引先の名前まで一度に出そうとせず、まずrequestsだけで答えられる問いに絞ります。対象はstateがopenの行です。
SELECTの後に表示したい列、FROMの後に元の表、WHEREの後に対象の条件を書きます。最後のORDER BYで並び順を指定します。今回は依頼IDの昇順なので、1、3、6の順です。登録した順に見えた経験があっても、並び順の指定なしに毎回その順になることを前提にしないでください。
SELECT request_id, job_id, detail, minutes
FROM requests
WHERE state = 'open'
ORDER BY request_id;期待する結果は、依頼1の文字のコントラストが30分、依頼3の写真の切り抜きが20分、依頼6の音量の調整が25分です。完了済みの2と4、取り下げた5は表示されません。ただし元のrequestsから削除されたわけではなく、今回の問合せの結果に含まれなかっただけです。
この区別は、表示がすっきりしたときほど意識します。未処理一覧に三行しか見えないからDBにも三行しかない、と判断すると、後で件数が合わなくなります。条件を付けない全列のSELECTへ戻れば六行を確認できます。SELECTで見せ方を変えることと、DELETEで元の行を消すことは別の操作です。
件数と分数を別々に検算する
次は未処理の件数と分数を一行の結果へまとめます。COUNT(*)は対象行の数、SUM(minutes)はその分数の合計です。ASの後に付けた名前は出力の見出しであり、元表の列名を変更していません。open_requestsとopen_minutesを見れば、件数と時間を取り違えにくくなります。
SELECT COUNT(*) AS open_requests,
COALESCE(SUM(minutes), 0) AS open_minutes
FROM requests
WHERE state = 'open';結果は3件・75分です。3は依頼IDが1、3、6の三つあることから、75は30+20+25から求められます。集計文の結果同士だけを比べるより、少数の元行を見て手計算した値と照らす方が、条件の取り違えを見つけやすくなります。この教材では見積分数の意味を一つに固定しており、実績時間や経過日数は混ぜません。
例えば取り下げた依頼5の15分を誤って足せば90分になります。これはSUMが足し算を間違えたのではなく、どの状態を含めたかが変わった結果です。また、完了済みも含めた全依頼の合計と比べて数字が少なくても、それだけでは不具合ではありません。集計を確認するときは、式より前に対象の条件へ戻ります。
COALESCEは、SUMの結果がNULLになったときに0を表示するために置いています。後で全件を一時的にdoneへ更新すると、openに合う行がなくなります。その場合も「未処理件数0、未処理分数0」と読めるようにします。元のminutesを全部0へ書き換える命令ではなく、問合せ結果の空いた値をどう表すかの指定です。
COUNTとSUMでは、対象がない場合の結果が同じではありません。ここをまとめて「何もないから全部空欄」と考えると、数字の意味を見失います。元行が存在するか、件数がいくつか、合計欄に何を表示するかを順に分けてください。集計関数の挙動はSQLite公式の集計関数で確認できます。
日付未定はNULLとして探す
案件301の案内PDFは日付を未定にしました。NULLはこの教材では「値がまだ決まっていない」を表します。空文字や「未定」という文字列とは異なる値なので、探す条件にもIS NULLを使います。日付が決まった案件と未定の案件を分けて出せれば、NULLを単なる表示上の空白として扱わずに済みます。
SELECT job_id, title, due_on
FROM jobs
WHERE due_on IS NULL
ORDER BY job_id;期待する行はjob_idが301、titleが案内PDFです。due_on欄の見え方は出力設定によって空欄に見えることがあります。見た目だけで空文字と断定せず、IS NULLの条件で取り出せたという意味を読みます。NULLを探すつもりで通常の等号比較に置き換えると、同じ結果にはなりません。
この表のdue_onはTEXT列で、カレンダーとして妥当な日付を自動検査する設計にはしていません。2026-11-05のように年・月・日をそろえて入れていますが、それだけで存在しない日付をすべて拒否できるわけではありません。この記事では日付計算へ広げず、決まった値と未定の値を分けて持つ練習に限定します。
零行、NULL、エラーを見分ける
「結果が出ない」ときにも違いがあります。条件に合う依頼がないSELECTは、正常に実行されて零行になる場合があります。列名を間違えれば、必要な列が見つからないというエラーになります。さらに、集計結果の一項目がNULLであることは、SELECT全体が失敗したことを意味しません。まずエラーの有無、次に結果の行数、最後に各欄の値を見ます。
SELECT *は全列を眺める際には便利ですが、後で結果をファイルへ渡すときは、列を明記しておく方が用途を伝えやすくなります。依頼一覧には内容が必要でも、案件別の負荷表では件数と分数が中心です。目的に合わせた列を選ぶ練習は、不要な情報を含めずに結果を説明する準備にもなります。
ここまでで未処理の三つの依頼は分かりましたが、その取引先名や、依頼が一つもない案件は一覧から読み取れません。requestsだけを見ているためです。次章では表を関連付け、依頼が存在しない案件も含めた四案件の状況へ視点を広げます。
修正がない案件も残し、JOINと集計で作業量を読む
同じ案件IDを手掛かりに表を結ぶ
JOINを使うと、別々の表にある情報を対応付けた結果を作れます。jobsの案件名とrequestsの修正内容を一緒に見たいなら、両方のjob_idが等しい行を結びます。今回はjをjobs、rをrequestsの短い呼び名にしています。j.job_idと書けば、どちらの表の列を指すかが明確になります。
SELECT j.job_id, j.title, r.request_id, r.detail
FROM jobs AS j
JOIN requests AS r ON r.job_id = j.job_id
ORDER BY j.job_id, r.request_id;結果は6行です。案件101には依頼1と2があるため、案件名のバナー制作も二度表示されます。これは同じ案件がDBに二つ登録されたという意味ではありません。一行の単位が、この問合せでは「案件と、それに対応した依頼の組合せ」へ変わっています。元のjobsを数えれば4件のままです。
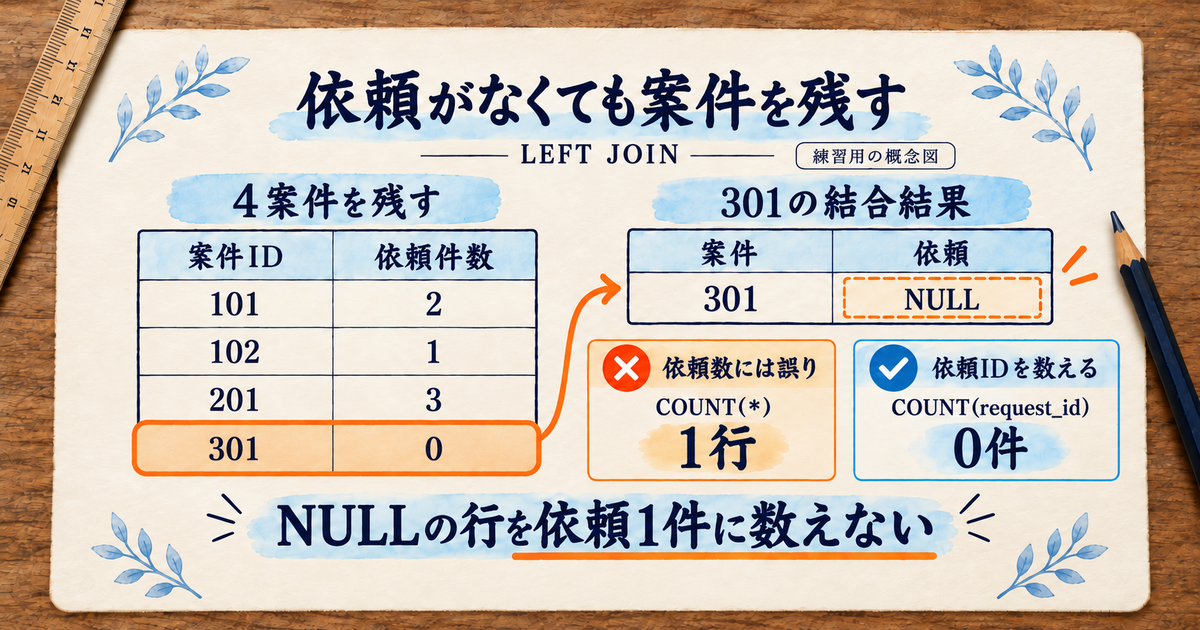
案件102は依頼3と一組、案件201は依頼4・5・6と三組になります。一方、依頼がない案件301は対応する組を作れないため、この結果には出ません。未処理の仕事を探すだけならそれでよい場面もありますが、全案件の状況を一覧にしたい場合には、案件301が存在することも残す必要があります。
LEFT JOINで依頼がない案件を残す
左側に置いたjobsの案件を残したいので、LEFT JOINに変えます。対応する依頼がない案件301には、右側のrequestsの欄がNULLになった行が補われます。この結果は、依頼のある6行に案件301の一行を加えた7行です。七つの修正依頼があるという意味ではありません。
SELECT j.job_id, j.title, r.request_id, r.detail
FROM jobs AS j
LEFT JOIN requests AS r ON r.job_id = j.job_id
ORDER BY j.job_id, r.request_id;ここでCOUNT(*)を使うと、案件301の補われた一行も数えます。依頼がない案件を0件と表したいなら、実在する依頼の主キーr.request_idを数えます。主キーは登録済みの依頼では値を持ち、LEFT JOINで補われた側ではNULLになるため、COUNT(r.request_id)が目的に合います。
SELECT j.job_id,
COUNT(*) AS joined_rows,
COUNT(r.request_id) AS request_count
FROM jobs AS j
LEFT JOIN requests AS r ON r.job_id = j.job_id
GROUP BY j.job_id
ORDER BY j.job_id;案件101、102、201の依頼件数は順に2、1、3で、案件301は0です。301のjoined_rowsだけは1になります。同じ問合せの中に二つの数を出すと、何を数えた違いなのかが見えます。COUNT(*)自体が誤った関数なのではなく、結合後の行数を依頼件数として読んだときに意味がずれるのです。
また、GROUP BYは、ここでは案件IDごとに行をまとめる指定です。元のrequestsの行を一つに削減して保存する操作ではありません。表示を案件単位へ変えながら、依頼の詳細は元表に残ります。個別依頼の一覧と案件別の集計を、同じDBから作り分けられることがSQLの使いどころです。
未処理条件を置く場所で、残る案件が変わる
全案件を残したまま未処理だけを数えるには、LEFT JOINのONへstateの条件を加えます。すると、案件と対応させる依頼をopenに絞り、該当する依頼がない案件も左側の行として残せます。単にLEFT JOINと書くだけで、後にどんな条件を置いても四案件が残るわけではありません。
比較のため、次のSELECTを実行してみます。これはWHEREで結合後の行をopenだけに絞った例です。初期状態では案件101、102、201の三行になり、右側がNULLの案件301は条件に合わず消えます。元表を変えない比較用の問合せですが、全案件の負荷表として採用するSQLではありません。
SELECT j.job_id, COUNT(r.request_id) AS open_requests
FROM jobs AS j
LEFT JOIN requests AS r ON r.job_id = j.job_id
WHERE r.state = 'open'
GROUP BY j.job_id
ORDER BY j.job_id;「未処理のある案件だけを探す」という問いなら、この三行にも意味があります。一方、今作りたいのは、依頼がない案件も含めて四案件の状況を確かめる表です。どちらの結果が正しいかは問いによって決まります。ONとWHEREを機械的に言い換えず、零件の案件を残したいかを先に決めてください。
結合と条件の扱いはSQLite公式のSELECTの説明に基づきます。本稿の案件301を手掛かりに読み直すと、NULLが補われる段階と、条件で結果から外れる段階を具体的に区別できます。
取引先名を加えた四列を、最後まで同じ形で使う
ここからはclientsも結び、取引先ラベル、案件ID、未処理件数、未処理分数の四列に固定します。clientsとjobsはclient_idで、jobsとrequestsはjob_idでつなぎます。今回は取引先のない案件を登録できない条件を作っているので、最初のJOINで四案件が対応し、その後のLEFT JOINで未処理依頼の有無を扱います。
SELECT
c.label AS client_label,
j.job_id,
COUNT(r.request_id) AS open_requests,
COALESCE(SUM(r.minutes), 0) AS open_minutes
FROM clients AS c
JOIN jobs AS j ON j.client_id = c.client_id
LEFT JOIN requests AS r
ON r.job_id = j.job_id AND r.state = 'open'
GROUP BY c.client_id, c.label, j.job_id
ORDER BY j.job_id;表は横にスクロールできます。
| client_label | job_id | open_requests | open_minutes |
|---|---|---|---|
| Sample A | 101 | 1 | 30 |
| Sample A | 102 | 1 | 20 |
| Sample B | 201 | 1 | 25 |
| Sample C | 301 | 0 | 0 |
Sample Aが二行あるのは、この表が取引先別ではなく案件別だからです。取引先名が同じという理由で二行を重複扱いして消すと、案件102が抜けます。出力の一行の単位を、列見出しと一緒に説明できることが大切です。今回はjob_idの昇順で、四案件が各一行ずつ残ります。
案件301のopen_minutesは、依頼側に合計できる値がないためSUMが返すNULLをCOALESCEで0にしたものです。案件301の予定日まで0へ変わったわけではありません。同じNULLでも、何の列に由来し、どんな目的で表示を補うかが異なります。
四行のopen_requestsを足すと3、open_minutesを足すと75です。第三章でrequestsから直接求めた値と一致します。結合によって行が増える場面を通ったあとでも、目的に合った集計に戻せたことを確認できます。この四列のSELECTを最終章でも使い、更新前後の差を同じ形で比べます。
一件だけ更新し、ROLLBACKとCOMMITの違いを確かめる
確定前に止まれる区切りを作る
ここからは元の行を変更します。SELECTとは異なり、UPDATEは保存される値に作用します。条件なしの更新を試す箇所があるため、いま開いているものがこの記事専用の練習DBであることを.databasesで確認してください。業務用DBへ同じ実験を持ち込む手順ではありません。
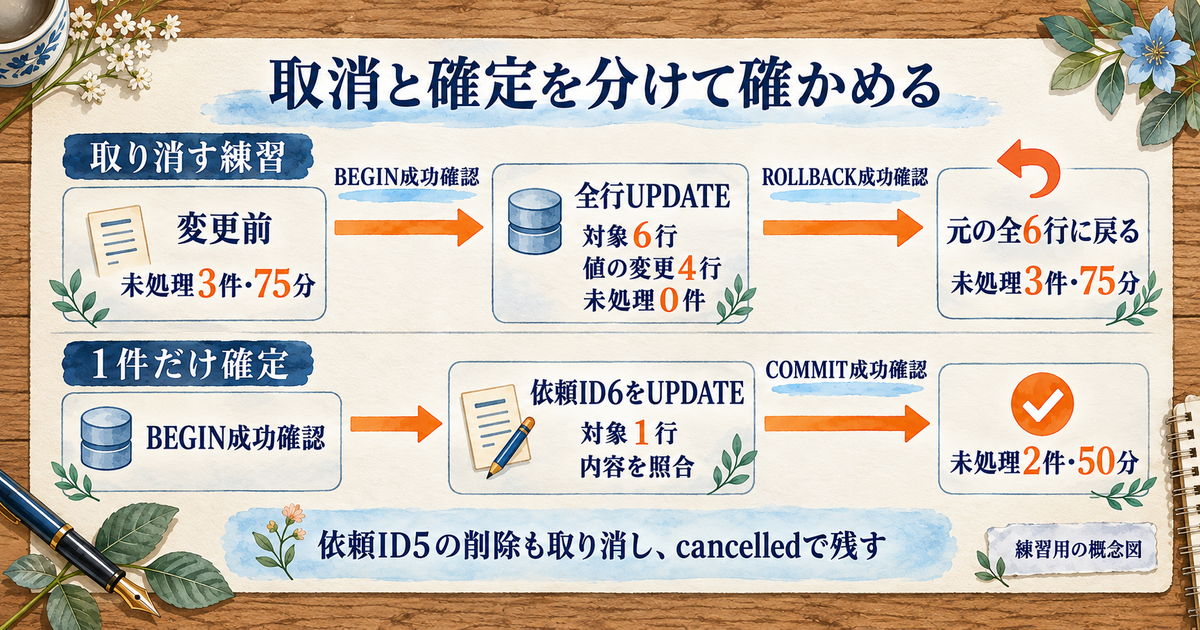
BEGINで明示的なトランザクションを始めると、変更内容を確認してからCOMMITで確定するか、ROLLBACKで未確定の変更を取り消すかを選べます。重要なのは、更新後に都合よく取消機能を付けることはできない点です。今回は更新前にBEGINを成功させ、その区切りの中で操作します。
BEGINだけを単独で送信し、エラーが表示されず通常の入力待ちへ戻ったことを確認してから、次のUPDATEを別に入力します。すでにトランザクションがあるというエラーなどが出たら、後続へ進みません。BEGINと更新を一括貼付すると、開始に失敗したのに変更を続ける危険があるためです。
この章は、一段階ずつ確認して進めます。BEGIN、変更、読戻し、COMMITまたはROLLBACKを分けて実行します。想定外のエラーが出たら後続を止めます。現在のトランザクション内と確認できる場合はROLLBACKと読戻しで止まり、状態不明のままCOMMITしません。
条件を付けない更新を試し、全六行を元へ戻す
まず第二章の全列SELECTと第三章の未処理集計を実行し、依頼1・3・6がopen、2・4がdone、5がcancelled、未処理3件・75分であることを確認します。この開始状態が違えば実験を始めません。初期状態を記録してからBEGINへ進みます。
BEGIN;BEGINの成功を確認できたら、次のUPDATEだけを実行します。ここにはWHEREがありません。結果として、requestsの全6行が更新の対象になります。
UPDATE requests SET state = 'done';SELECT changes() AS affected_rows;この教材の結果ではaffected_rowsが6になります。6はUPDATEの対象になった行数です。元からdoneだった依頼2と4も含まれるため、stateの値が実際に変わったのは依頼1・3・5・6の4行です。「6行が対象」と「6行の値が変化した」を同じ意味で使わないでください。
SELECT request_id, job_id, detail, state, minutes
FROM requests ORDER BY request_id;SELECT COUNT(*) AS open_requests,
COALESCE(SUM(minutes), 0) AS open_minutes
FROM requests WHERE state = 'open';六行のstateはすべてdoneになり、未処理は0件・0分です。取り下げ済みの依頼5まで完了へ変わっているので、意図した結果ではありません。件数が6だったことだけで判断せず、全列を読み、何が変わったかを確かめた上で取消へ進みます。
ROLLBACK;ROLLBACKの実行が成功したことを確認したら、直前の二つのSELECTをもう一度実行します。全6行の全列が初期データに一致し、未処理のIDが1・3・6、合計75分へ戻ることが到達条件です。stateだけ戻っているように見えることや、行数だけ6であることでは確認を終えません。
この実験で、WHEREの付け忘れがどの範囲へ作用するかを見られました。UPDATEの条件と対象については公式のUPDATE文、changes()の範囲については組み込み関数の説明が根拠です。今回の表にはトリガーを設けていないため、その間接変更などを含む複雑な件数は扱いません。
依頼6だけを完了へ変えて確定する
次は音量の調整を終えたという架空の状況です。まず依頼6をSELECTし、案件201、内容が音量の調整、stateがopen、minutesが25であることを読みます。番号だけでなく内容を確かめれば、思っていた仕事とは違う行を更新する取り違えに気付きやすくなります。
SELECT request_id, job_id, detail, state, minutes
FROM requests WHERE request_id = 6;BEGIN;新しいBEGINの成功を確認してから、次の更新へ進みます。条件には依頼IDに加えて、現在のstateがopenであることを含めます。自分が想定した更新前の状態に合う行だけを対象にするためです。
UPDATE requests
SET state = 'done'
WHERE request_id = 6 AND state = 'open';SELECT changes() AS affected_rows;初期状態から正しく進めていれば対象は1行です。もし0なら、すでにdoneになっているのか、違うDBを開いているのか、依頼6がないのかを確認します。0を表示しただけでは構文エラーとは限りませんが、狙いどおり更新できたとも言えません。条件を外して強制的に変更する前に、対象行を読み直します。
SELECT request_id, job_id, detail, state, minutes
FROM requests ORDER BY request_id;SELECT COUNT(*) AS open_requests,
COALESCE(SUM(minutes), 0) AS open_minutes
FROM requests WHERE state = 'open';ここで、依頼6だけがdoneへ変わり、他の五行は初期状態のままかを照合します。依頼6のminutesは25のままで、作業が終わったからといって0へ書き換えていません。未処理の集計からその25分が外れるため、75−25=50分、残る依頼は1と3の二件になります。
件数1、対象行の内容、他の行、未処理2件・50分のすべてが一致したら、次のCOMMITを単独で実行します。何か違えば確定せず、トランザクション内であると確認できる間にROLLBACKしてから原因を調べます。
COMMIT;COMMITの成功も画面で確認します。エラーが出たのに確定済みとして閉じたり、別の変更を重ねたりしません。成功した後の変更は、このトランザクションに対するROLLBACKでは元へ戻りません。戻す必要がある場合は別の修正を検討することになり、この実習では確定済みの依頼6を元へ戻す操作は行いません。
削除も試すが、取り下げ履歴は残す
削除の練習にはcancelledの依頼5を使います。これは取り下げた依頼を日常運用で消すことを勧めるものではありません。DELETEでは行自体がなくなるため、状態をcancelledとして残す方法と、見返せる情報がどう違うかを確かめます。今回の削除は確定せず取り消します。
BEGIN;BEGINが成功したことを確認してから、一文だけ削除します。依頼IDと状態の両方が一致する行を対象にします。
DELETE FROM requests
WHERE request_id = 5 AND state = 'cancelled';SELECT changes() AS affected_rows;SELECT request_id, job_id, detail, state, minutes
FROM requests ORDER BY request_id;対象は1行で、表示される依頼は1・2・3・4・6の五行です。依頼6は直前に確定したdoneのままです。削除対象と残りの内容を読んだら、ROLLBACKを単独で実行します。
ROLLBACK;取消の成功後、全列SELECTで六行へ戻り、依頼5がcancelled、依頼6がdoneであることを確かめます。今回のROLLBACKが取り消すのは、最後のBEGIN以降の削除です。先にCOMMITした依頼6の完了まで取り消すわけではありません。区切りごとに何を確定したかを記録すると、この違いを追いやすくなります。
エラーが出たときの扱いも、すべて同じではありません。制約違反が発生しても、それだけでDB全体が必ず初期状態へ戻るとは限りません。直前までの成功操作と、未確定の範囲を確かめます。トランザクションの正式な説明はBEGIN・COMMIT・ROLLBACK、削除の対象はDELETE文で確認できます。
DBを開き直し、結果CSVと復習用コピーを分けて残す
同じフルパスで再開し、確定した状態を読む
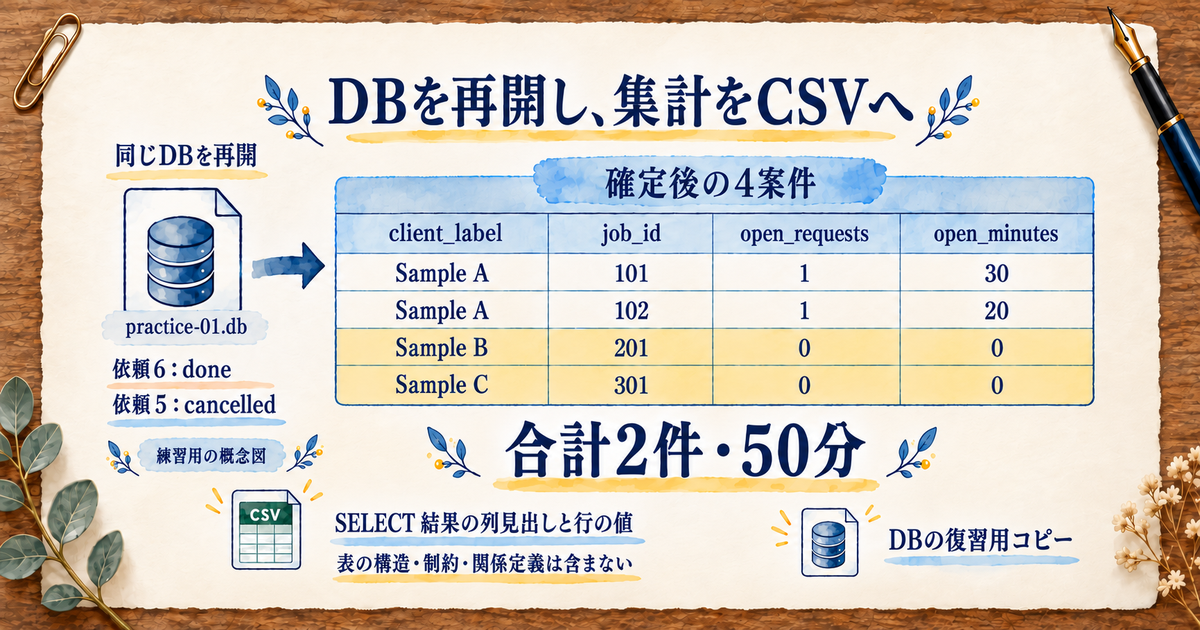
第五章を終えた時点で、依頼6の完了は確定し、依頼5の削除は取り消されています。この状態をいったん閉じてから読み直し、画面で見えていた内容が、目的のDBに残っているかを確かめます。未確定の操作が残っていないことを確認した上で.quitを実行します。
.quitsqlite3を再び起動し、第一章で実際に採用したDBの同じフルパスを.openで指定します。途中でpractice-02.dbへやり直したなら、その名前を使います。存在するはずのファイルがエクスプローラーで見つからないときは、似た名前を入力して新しいDBを作らず、保存した場所を調べてください。
.open "実際の練習フォルダーのフルパス/practice-01.db".databasesmainのフルパスが一致したら、新しい接続にも外部キー設定を行います。DBを保存したことと接続設定を引き継いだことを混同しないため、ここでもBEGINの外で設定と読戻しを分けます。
PRAGMA foreign_keys = ON;PRAGMA foreign_keys;1を確認し、.headers on、.mode boxをそれぞれ一行で設定します。第二章の件数確認SQLで取引先3・案件4・依頼6を読み、依頼の全列SELECTで5がcancelled、6がdoneと確かめます。表がない場合は、保存が失敗したとすぐに決めつけず、まず別の空DBを開いていないかを調べてください。
再開後の確認は、ファイル名を覚えるだけの練習ではありません。確定した変更と取り消した変更が、それぞれどう残るかを別の接続で読む機会です。合計値が合っているだけでは、違う依頼を完了にしていても気付けない場合があります。依頼5と6の内容を先に見た上で、四案件の集計へ進みます。
最終結果は四案件、未処理二件、合計五十分
第四章と同じ四列のSELECTを実行すると、今度は案件201の未処理が0件・0分になります。案件201に修正依頼そのものがないのではありません。登録した依頼4・5・6は残っており、それぞれdone、cancelled、doneなので、openに該当しなくなったという意味です。
もともと依頼がない案件301も、未処理集計では同じ0件・0分です。この表だけでは、「依頼があるが未処理はない」と「依頼自体がない」を区別できません。その違いを知りたいときは第四章の全依頼件数を見るなど、問いに合う別の結果を使います。零という数字にも、どう抽出したかという背景があります。
表は横にスクロールできます。
| client_label | job_id | open_requests | open_minutes |
|---|---|---|---|
| Sample A | 101 | 1 | 30 |
| Sample A | 102 | 1 | 20 |
| Sample B | 201 | 0 | 0 |
| Sample C | 301 | 0 | 0 |
四案件は残り、未処理の合計は2件・50分です。取引先の数3、案件の数4、依頼の総数6、未処理の数2という四つの数は、それぞれ別の対象を数えています。結果を誰かに説明するときにも「全部で何件」だけで済ませず、何の件数なのかを付けて伝えましょう。
CSVにはSELECTの結果を一回だけ書き出す
CSVは、ここで選んだ列見出しと行の値を外へ出すために使います。元表をそのまま出す場合もあれば、今回のようにJOINと集計をした結果を出す場合もあります。一方、元の表構造、入力制約、表の関係の定義や、別の問合せまで一緒に保存されるものではありません。
まず練習フォルダーにfinal-workload-01.csvが存在しないことを確認します。すでにあるなら02などの未使用名へ変え、以前の結果を上書きしないようにします。以下はCLIの公式手順に沿った書出し例であり、本稿制作時にこのCLI出力を実機で確認したものではありません。各命令の結果を読んでから次へ進めてください。
.headers on.mode csv.once "実際の練習フォルダーのフルパス/final-workload-01.csv".onceは次の一回の出力先を指定します。ここから次のSELECTまでの間に、確認用のPRAGMAや別のSELECTを挟まないでください。次に送る問合せを、以下の四列のSELECT一文にそろえます。
SELECT
  c.label AS client_label,
  j.job_id,
  COUNT(r.request_id) AS open_requests,
  COALESCE(SUM(r.minutes), 0) AS open_minutes
FROM clients AS c
JOIN jobs AS j ON j.client_id = c.client_id
LEFT JOIN requests AS r
  ON r.job_id = j.job_id AND r.state = 'open'
GROUP BY c.client_id, c.label, j.job_id
ORDER BY j.job_id;SELECTがエラーなく終わったことを確認し、次の命令で表示をboxへ戻します。設定やSELECTが失敗した場合、空のファイルができていても書出し成功とはしません。その場で止め、出力先とエラーを確かめます。
.mode box保存先のCSVをテキストエディターで開き、列の順序と値を確かめます。以下は一致すべき値を示す標本です。実際のCLI出力は引用符の付け方や改行形式が異なる場合があるため、文字列全体の見た目ではなく、CSVとして読んだ四列・四データ行を照合します。
client_label,job_id,open_requests,open_minutes
Sample A,101,1,30
Sample A,102,1,20
Sample B,201,0,0
Sample C,301,0,0
見出しを含めて五行、データは四行です。301だけでなく201も零件の行として残っているかを確認します。表計算ソフトで開いた場合は、文字や数値が自動変換されることがあります。見え方が違うときには、まずテキストの値を読み、DBの保存内容の誤りと、開いた側の表示や変換を分けて調べます。
DBのコピーは、結果ファイルと別に作る
復習で表の定義や登録内容も開き直したいなら、CSVとは別にDBのコピーを残します。CLIには.backupがあり、指定したDBのコピーを作るために使えます。動作中のDB本体だけをエクスプローラーで複写すれば、どんな状態でも安全なバックアップになる、と考えないでください。
今回は未確定の変更を残さず、練習フォルダー内の未使用名practice-copy-01.dbを確認してから、mainをコピー元に指定します。この.backupも公式CLIに基づく未実機試験の手順です。元DBを開いたまま、出力先が元と異なるフルパスであることを読んで実行します。
.backup main "実際の練習フォルダーのフルパス/practice-copy-01.db"エラーがないこととコピー先のファイルがあることを確認しただけでは、内容の照合は終わりません。復習用コピーを検査するときは、元DBのフルパスをメモに残した上でコピーを.openし、.databasesでコピー先を確認します。外部キーを設定して1を読み、取引先3・案件4・依頼6、5のcancelled、6のdone、最終の四案件集計を同じように照合します。
コピーの中身が違う場合は、そのまま元DBへ上書きしません。どの時点のファイルをコピーしたか、実際にどちらを開いているかを調べます。以降、元の実習へ戻るなら元DBのフルパスを.openで指定し、接続設定を改めて確認します。コピーを作ることと、コピーから再開できることは、別々の確認項目です。
接続中のDBに対して、次の二つの検査も使えます。foreign_key_checkで結果が零行なら、その検査で外部キー違反が報告されていないことを示します。integrity_checkがokなら、その整合性検査の範囲で問題が見つからなかったという意味です。両方とも、依頼6を完了にすべきだったかという業務判断を検証するものではありません。
PRAGMA foreign_key_check;PRAGMA integrity_check;検査の役割の違いはSQLite公式のPRAGMA一覧、コピーの考え方は公式のバックアップ解説で確認できます。検査結果に問題が出たら、エラーを残してそこで止めます。結果を消すために制約を無効化したり、元DBを削除したりする必要はありません。
残すのは、DB、結果、操作の理由
最後に、DBには表と登録データ、CSVには今回選んだ四列の集計、練習メモには使ったSQLと確認した状態を残します。例えば「依頼6だけを完了にした」「依頼5の削除は取り消した」「未処理2件・50分を同じDBの再開後に確認した」と書けば、後から結果の理由をたどれます。画面の数字だけを控えるより、どこをどう変えたかが伝わります。
独学の次の課題は、コードを増やすことより、この例を見ずに一行の単位と更新範囲を説明することです。案件301が消えない理由、対象6行でも値が変わるのは4行である理由、削除の取消後も依頼6がdoneのままである理由を、自分の言葉で整理してみてください。説明が詰まった箇所を、その章の小さなSELECTで確かめ直すと復習が具体的になります。
この練習を仕事につなげたい場合は、まずデータ分析の副業で求められる成果物と案件選びで、操作以外に必要な確認範囲も整理できます。案件の探し方を比較したい人はクラウドソーシング副業の始め方、追加学習の費用や支援を検討する人は副業向けプログラミングスクールの比較を、必要に応じて参照してください。
一つの教材を終えたことだけで、実際の顧客DBを安全に扱えるとは限りません。それでも、保存先を確かめ、少ない元行から検算し、未確定の変更を戻し、確定後に読み直すという流れは、次の学習でも使えます。SQLiteの最初の一歩は、たくさんの文法を並べることより、一つのDBで起きた変化を最後まで説明できることに置きましょう。