robots.txtの書き方|副業の保守案件で誤った拒否を防ぐ設計と確認
※本記事にはPRを含む場合があります。
こんにちは。『脱会社員』脱サラを応援し続けるブログ、運営者の『なかびー』です。
robots.txtの書き方は、対象のクローラーをUser-agentで指定し、取得を控えてほしいパスをDisallow、拒否範囲の中で許可する例外をAllowで示すのが基本です。ただし、保守の仕事で最初に確認するのは依頼の目的です。「この資料を見られなくして」という一言だけでは、書くべき規則を決められません。
副業で小規模サイトの更新を手伝っていると、「検索結果から古い資料を消したい」「検索結果ページを巡回させたくない」「顧客専用の資料を隠したい」という相談が、同じ設定変更として届くことがあります。この三つは必要な対応が異なります。依頼を一行の拒否規則へ置き換える前に、何ができれば完了なのかをそろえましょう。
この記事では、架空の制作室を題材に、目的の整理、既存設定の読解、URLごとの予想、承認に回す変更案までを作ります。すべて架空の机上教材で、実サイトのrobots.txtは変更していません。独自モデルによる固定32例の照合は行いましたが、Google公式パーサー、実クロール、HTTP応答、検索表示は未検証です。
読み終えたときの成果物は、本番に貼り付ける万能設定ではなく、依頼元が変更の範囲と残る確認を判断できる資料です。規則を読めることと、実施してよいことを分けながら進めます。
目的を整理し、robots.txtで扱う依頼を決める
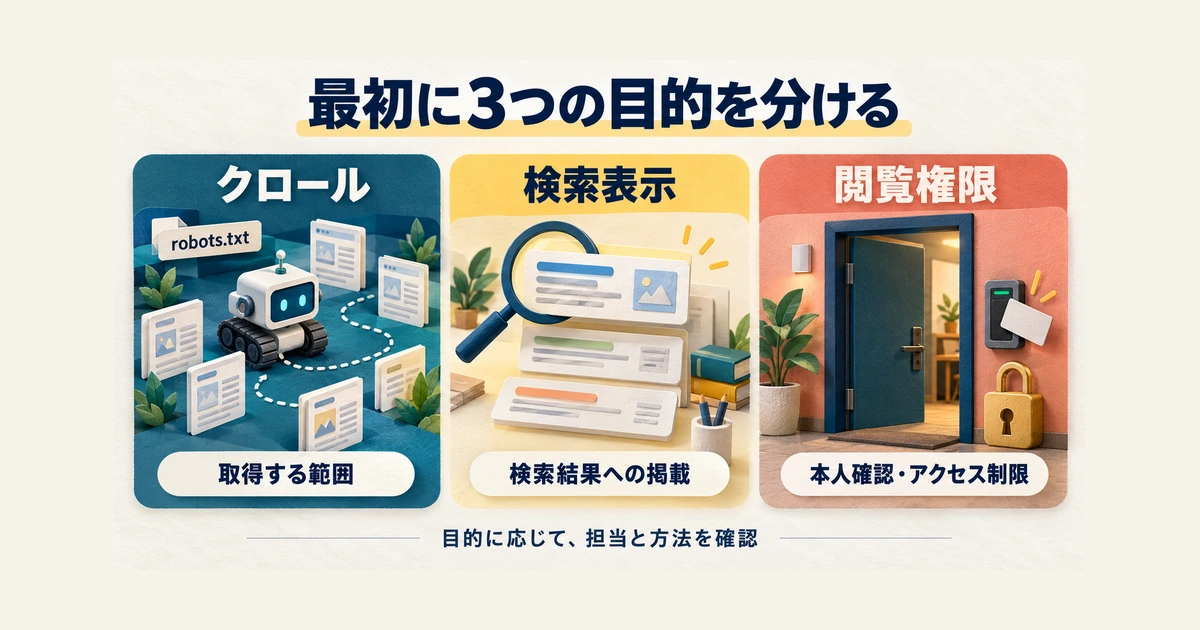
クロール、検索表示、閲覧権限は別の目的として確認します。
クロール・検索表示・閲覧権限を別々に考える
robots.txtは、対応するクローラーに取得してよい範囲を伝えるためのものです。人がブラウザーで開けるか、検索結果へ載るかという判断とは分けて扱います。たとえば作品紹介を広く読んでもらうサイトで、検索条件の違いによって増えるURLの取得を抑える相談なら、クロールの範囲を検討する理由になります。
一方、「Disallowと書けば秘密になる」と考えてはいけません。robots.txt自体は公開して読まれる前提のファイルであり、その指示を守らないクローラーも存在します。秘密資料の置き場所を書いても、閲覧に必要な本人確認やアクセス制限は追加されません。Googleの概要とRFC 9309も、アクセス保護の代わりに使わないよう説明しています。Googleのrobots.txtの概要、RFC 9309
Disallowで取得を拒否したURLでも、外部のリンクなどから発見され、本文のスニペットなしで検索結果に出る可能性があります。「クロールを拒否した」と「検索から消えた」は別の結果です。
※表は横にスクロールできます。
| 依頼の言葉 | 先に確かめる目的 | 今回の扱い |
|---|---|---|
| 検索結果ページを巡回させたくない | 特定URLの取得を抑えたい | robots.txtの変更案を検討 |
| 旧PDFを検索から消したい | 検索結果への掲載を止めたい | noindex等の適切な方法を別途確認 |
| 顧客以外に資料を見せたくない | 閲覧者を制限したい | アクセス保護の担当へ戻す |
| 作品ページを検索で見つけてもらいたい | 取得を妨げず公開を続けたい | 許可を守る対象として確認 |
noindexは、検索インデックスへの登録を制御する指示です。Googleにその指示を読んでもらうには、対象の内容を取得できる必要があります。先にrobots.txtで拒否すると、追加したnoindexを読めなくなる場合があります。robots.txtの中へ「noindex:」という行を足す方法も、Google向けの有効な設定として案内しません。Googleのnoindex解説
ここで必要なのは、相談のたびに自分の権限で別の設定へ変更することではありません。「閲覧できなくする」「検索掲載を止める」「取得を控えてもらう」のどれかを依頼元と確認し、権限と担当がある工程へ戻すことです。サイト全体の保護についてはWordPressのセキュリティ対策も参考になりますが、変更の前には利用環境と担当者の確認が必要です。
架空の依頼を、判定できる条件へ書き直す
今回の依頼元は、公開の作品サイト「atelier.example」を運営する架空の制作室です。作品ページと表示用CSSの取得は妨げず、/search/配下の検索結果は取得を抑えたいとします。ただし、使い方を説明する/search/help/配下は読ませます。さらに、/archive/配下でURL末尾が小文字の.pdfになる資料を対象にします。
Googlebotについては、公開して差し支えない見本ページ/preview-demo/も取得を抑える設定を比較します。ほかの教材用エージェントには、その追加条件を適用しません。この見本ページも古いPDFも、秘密資料ではありません。検索結果から削除する依頼も含めず、ここでは取得範囲だけを検討します。
「検索関係を全部」「PDFなら全部」という書き方では、例外が消えてしまいます。依頼メモには、対象パスと例外、対象クローラーを分けて残してください。「末尾が.pdf」の意味を狭く決めているのも教材上の条件です。実案件で、クエリ付きの同じ資料まで対象にするかどうかは、その言葉だけでは決められません。
依頼元への確認文は、「今回の目的は検索結果からの削除ではなく、指定URLの取得を抑えることで合っていますか。作品ページと説明ページは取得可能に保ち、顧客専用資料の保護は別担当へ確認します」で十分です。相手に専門用語だけを選ばせず、変更後の状態を短く説明すると、認識の違いが見つかります。
変更しない判断も、作業の成果にする
目的が確認できても、既存の規則がすでに満たしているなら、新しいファイルや行は不要かもしれません。ホスティングサービスに専用の設定があり、直接編集を必要としない場合もあります。Googleの作成ガイドもサービスによる違いを案内しています。まず現状を読み、差分が必要なのかを決めましょう。Googleの作成・設定ガイド
反対に、「検索流入を増やしたいから拒否を全部消す」という依頼は、対象と影響がまだ不明です。残している規則に理由があるか、誰が設定したかを調べます。作業をした形を作るために変更せず、調査結果として「今回は保留」「別の制御が必要」と返せることが、小さな保守案件でも大切です。
対象サイトと既存の規則を読み取る
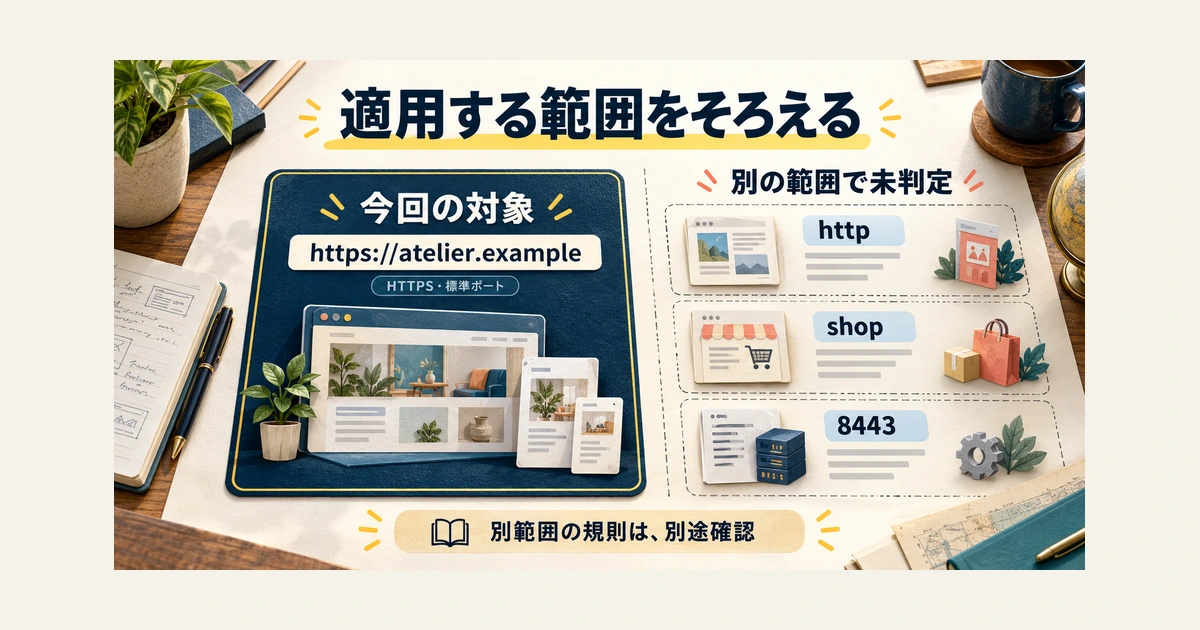
今回の対象と、別の範囲で確認が必要なURLを分けます。
プロトコル・ホスト・ポートを一組にする
今回の教材で規則を置く想定は、https://atelier.example/robots.txtです。対象はHTTPS、atelier.example、標準ポートの組です。似たドメイン名を見つけても、同じ規則で判断できるとは限りません。対象サイトを省略せず書くと、ショップのサブドメインや検証環境を一緒に変更する取り違えを防ぎやすくなります。
※表は横にスクロールできます。
| 確認するURLの範囲 | 教材での扱い | 確認すること |
|---|---|---|
| https://atelier.example/ | 今回の対象 | この範囲の規則案を読む |
| http://atelier.example/ | 別範囲で未判定 | HTTP側の管理を別に確認 |
| https://shop.atelier.example/ | 別範囲で未判定 | ショップ側の担当を確認 |
| https://atelier.example:8443/ | 別範囲で未判定 | 非標準ポート側を別に確認 |
表の三つの別範囲は、元32例のR15〜R17に対応します。教材ではOUT_OF_SCOPEと記録しますが、それは「クロールを許可する」という意味ではありません。こちらのrobots.txtを当てはめられず、相手側の規則も調べていないため、許可・拒否をまだ判断できないという区分です。別範囲の設定を勝手に推定しないでください。
ただし、URLの見た目が違えば常に別範囲になるわけでもありません。HTTPSの標準ポート443を明示した表記は、省略したものと同等です。通常のHTTP(S)取得では空のパスと/に同等性があり、schemeとhostの大小文字も区別しません。パスの大小文字の扱いとは別です。Googleの適用範囲の説明、RFC 9110の正規化と比較
今回の簡易モデルは、この正規化を実装していません。標準443、大文字host、空パスなど、固定された入力と異なる文字列はUNSUPPORTEDとして判定を止めます。これは仕様上の同等性を否定する判定ではなく、教材が対応していないことの表示です。実案件へ使う汎用のURL判定器として流用しない前提を、ここで押さえておきましょう。
見えている内容と、編集する場所をつなげる
robots.txtは対象ホストのルートで提供されるUTF-8の書式なしテキストです。作成案を保存するときは、文書作成ソフトの装飾や自動置換が入らないテキスト形式を使います。ファイル名の後ろに別の拡張子が付いていないか、規則が全角のコロンや記号に置き換わっていないかも、読み返す箇所になります。
ただし、URLで見える内容が、必ずサーバー上の同名ファイルから出ているとは限りません。WordPressにはrobots.txtを出力する関数と、その内容を調整する仕組みがあります。実ファイル、CMSの出力、プラグイン、配信側の設定のどこが正本かを、利用中の構成に沿って確認します。WordPress公式のdo_robots
たとえば、管理画面で変えたのに表示が変わらない場合、同じ欄を何度も保存する前に、表示されている出力元を調べます。担当外のプラグインを停止したり、新しい実ファイルで上書きしたりすると、別の管理経路を壊すおそれがあります。編集権限がある場所と、実際に配信される場所がつながっていることを確認してから進めます。
取得結果がログイン画面、案内ページ、エラーHTMLだった場合も、robots.txtの原本として扱いません。URLを開けた事実、返ってきたHTTP状態、本文が意図した規則だったかを別々に記録します。この記事では実サイトの取得を行っていないため、いずれも設置担当が後で確認する項目です。
原本の控えに、対象と時刻と戻す人を付ける
規則を変更する前には、現状のテキストをそのまま控え、取得元と日時を記録します。比較しやすいように整形したコピーを作る場合も、取得したままの控えは別に残します。空行やコメントも含めて保存しておけば、変更理由のメモを消していないか、予定していない行が変わっていないかを確認できます。
控えの名前だけが「変更前」では、どのサイトのいつの状態か分からなくなります。「対象の組」「取得日時」「保存先」「取得担当」「管理元」を一つの記録にまとめましょう。ハッシュは内容の一致を確かめる補助になりますが、正しい場所から取得できたことや、復元できることを単独で保証するものではありません。
- 対象:プロトコル・ホスト・ポート
- 原本:取得URL・取得日時・本文・HTTP状態
- 管理:正本の所在・編集担当・設置担当
- 保全:控えの保存先・変更しない行・復元担当
robots.txtの控えと、サイト全体のバックアップは範囲が違います。元の出力へ戻すには、変更した設定や生成元を戻す作業が必要な場合もあります。WordPressのバックアップ方法を確認しつつ、この作業で誰がどこまで復元できるのかを決めておきます。パスワードや鍵を確認票へ書き込む必要はありません。
この章の終わりには、「どこを編集すればよいか」だけでなく、「触らない対象はどれか」まで言える状態にします。HTTP側、ショップ側、非標準ポート側は別確認。管理元や復元担当が分からない場合は、規則の提案まで進めても、本番への反映は保留にします。
AllowとDisallowをURLの範囲に合わせて書く
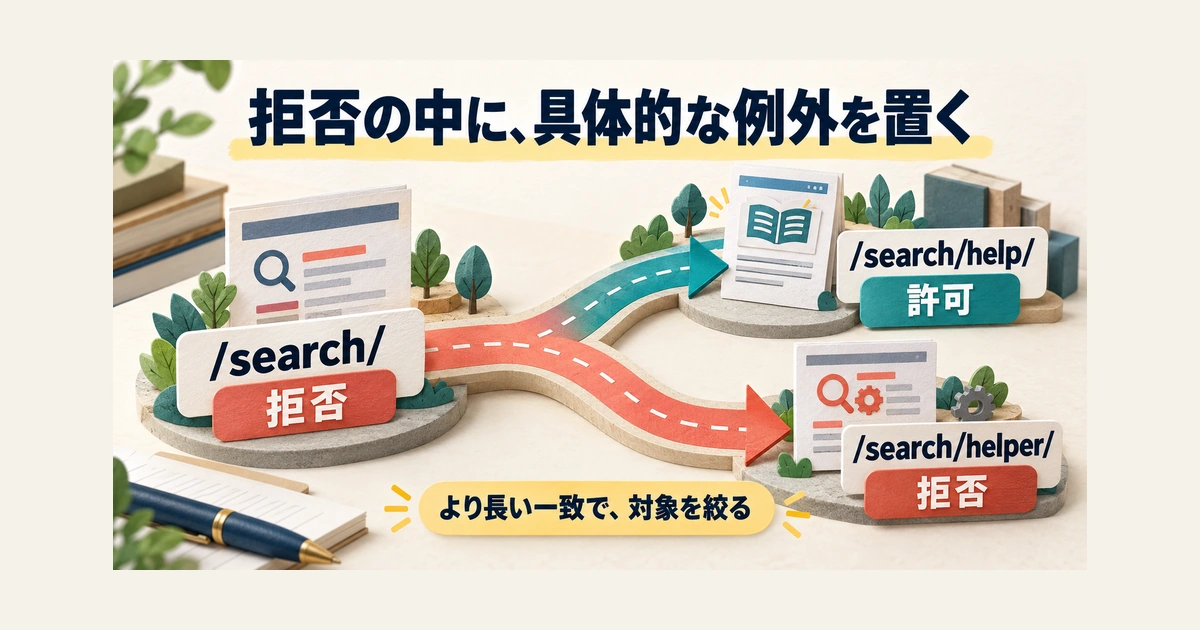
/search/の拒否に対し、/search/help/はより具体的な許可の例外です。
最小の規則を、依頼メモの一文と対応させる
教材のrobots-good.txtには、一般向けのグループとGooglebot向けのグループがあります。まず一般向けの部分を読みます。User-agentは対象、Disallowは取得を拒否する範囲、Allowはその中で許可する範囲です。グループの違いは次章で確認し、この段階では一組の規則とURLの関係に集中します。
User-agent: *
Disallow: /search/
Allow: /search/help/
Disallow: /archive/*.pdf$
この四行は、今回の架空依頼の範囲を表す教材です。自分のサイトへ貼り付けるひな型ではありません。最初の拒否は/search/で始まる対象を、次の許可はその中の/search/help/で始まる対象を扱います。最後の行は/archive/で始まり、小文字の.pdfで終わる対象を選びます。
規則を読む順序は、「このURLに一致する行はどれか」「複数あるならどの範囲がより具体的か」です。Googleの解釈では、より長く一致するパスの規則が優先され、同等の競合では制限の少ない規則が選ばれます。ファイルの最後の行が無条件に勝つ仕組みとして読むと、例外の意味を取り違えます。Googleのrobots.txt解釈仕様
helpとhelper、末尾スラッシュの違いを確認する
R04の/search/?q=cupは/search/に一致するため、教材での予想はDISALLOWです。R05の/search/help/index.htmlは、拒否と許可の両方に一致しますが、長い/search/help/の許可が選ばれてALLOWになります。「検索配下を抑え、使い方の説明は残す」という依頼の例外を、パスの違いで表しています。
ここで見落としやすいのがR06の/search/helper/です。文字の途中まで似ていますが、/search/help/には続きのスラッシュが必要なので一致しません。短い/search/の拒否だけが作用し、DISALLOWです。画面上のページ名が「ヘルプ関連」でも、規則はページの意味を読んで例外へ振り分けてくれるわけではありません。
R07の/searchは、末尾にスラッシュがないため/search/の拒否に一致せずALLOWです。R08の/Search/も、先頭のSが異なるのでこの拒否に一致しません。ここでは実際に同じページへ転送されるか、別のページなのかを調べていません。転送先の内容が似ているはずという想像で、教材の入力を書き換えないようにします。
この二つのALLOWを見つけたら、実務では「検索入口のスラッシュなしURLや大文字表記も拒否する意図ですか」と依頼元へ確認します。教材では許可が主依頼の条件なので、勝手に/searchへ短縮して拒否範囲を広げません。一文字の修正でも、/searchで始まるほかの名前まで巻き込む可能性を調べる必要があります。
ワイルドカードと末尾記号で、どこまで一致させるかを決める
/archive/*.pdf$の*は途中の文字列に、$は末尾に注目する記号です。R09の/archive/guide.pdfは対象になりますが、R10の/archive/guide.PDFは大文字なのでこの規則では対象になりません。拡張子らしく見える部分を自動で小文字へ直してから比較する、という説明にはしないでください。
R11の/archive/guide.pdf?download=1は、.pdfの後ろにクエリが続くので、.pdfで終わるという条件を満たしません。R12の/archive/guide.pdf/extraも同様です。どちらもこの教材ではALLOWです。同じPDFを開くためのURLに見えたとしても、URL文字列の末尾を条件にした規則である点を押さえます。
依頼が「その資料への取得を全部抑えたい」なら、この狭い条件だけでは不足する可能性があります。そこで対象URLの実態を調べ、クエリの種類や別名、生成元まで相談します。「?があるURLは全部拒否する」といった広い規則へ飛びつくと、絞り込み、必要なページ送り、表示に必要なURLなどを巻き込むおそれがあります。
規則を短くすること自体を目標にせず、許可しておくURLを先に隣へ並べましょう。今回なら作品ページとCSS、検索の使い方ページです。拒否予定のURLだけを確認すると、拒否を広げすぎても全部正解に見えてしまいます。新しく一致するURLが増える変更ほど、保護する側の確認が必要になります。
何も書かない範囲と、Sitemap行の役割を読む
この教材では、選ばれたグループに一致する拒否がないURLはALLOWです。作品ページ/works/cup/と/assets/site.cssには、この規則の拒否は一致しません。「許可する全ページをAllowで列挙しないといけない」と考える必要はなく、例外を説明するためのAllowと、何も拒否されていない状態を区別します。
robots-good.txtの末尾には、Sitemapとしてhttps://atelier.example/sitemap.xmlを記載しています。これはサイトマップの場所を知らせる行で、そこへ載せたURLの拒否を取り消すものではありません。サイトマップに作品が載っているから取得可能なはず、と判定を省かず、対象クローラーの規則で確認します。
サイトマップの生成や送信の手順はWordPressサイトマップの作り方で扱っています。ここで作るのは、その一覧にあるかどうかとは別に、URLへどの規則が作用するかを説明する資料です。案の各行に依頼メモ上の理由を付ければ、後から対象を増やすときも、どの条件を変える話なのかが分かります。
なお、この記事の例は短いASCII文字列に限定しています。日本語パスやパーセントエンコードの比較まで、この教材で確かめたわけではありません。扱うURLの文字種が変わる場合は、同じ見た目だから同じ結果と推測せず、対象仕様と確認方法を追加してから検討します。
クローラー別のグループと競合する規則を点検する
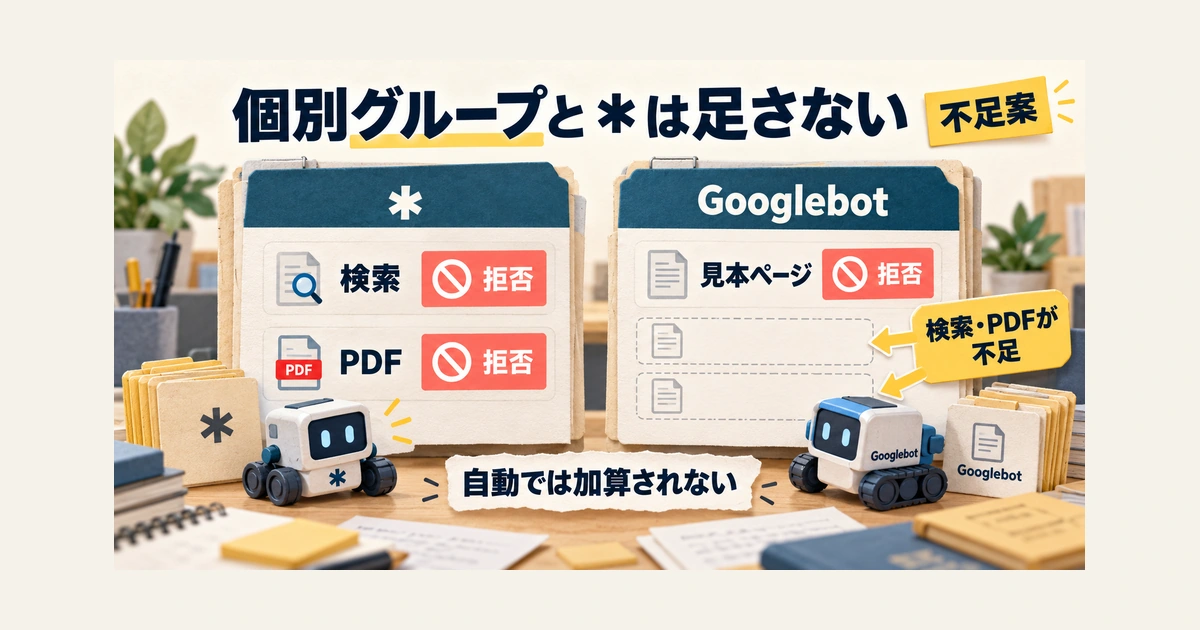
Googlebotの個別グループへ、*の規則は自動で加算されません。
個別グループへ、アスタリスクの規則を足さない
次は、意図的に不足を残したrobots-missing-group-rules.txtを読みます。一般向けの*には検索とPDFの拒否がありますが、Googlebotの個別グループには/preview-demo/の拒否しかありません。「全体の規則にGooglebot用の一行を追加した」と考えると見逃す構成です。
# Deliberately incomplete Googlebot group for this exercise.
User-agent: *
Disallow: /search/
Allow: /search/help/
Disallow: /archive/*.pdf$

User-agent: Googlebot
Disallow: /preview-demo/

Sitemap: https://atelier.example/sitemap.xmlGooglebotは、自分に対応する個別グループを使います。個別グループと*グループの規則は足し合わせません。この例では、検索とPDFの拒否がGooglebotのグループ内にないため、R18の検索結果とR20のPDFはALLOWになる予想です。規則を正しく解釈した結果でも、依頼が求めたDISALLOWとは食い違います。
R19の教材用Samplebotは、*のグループを使うため、同じ検索結果URLがDISALLOWになります。Samplebotはこの説明のために置いた架空のエージェントで、実在サービスの仕様を検証したものではありません。「あるbotで拒否になったから、Googlebotでも同じ」と判断せず、使用したグループを判定表に残す理由がここにあります。
不足の原因を依頼元へ伝えるときは、「Googlebot用グループを追加したことで、一般向けの検索・PDFの拒否を引き継がない構成になっています」と説明できます。単に「書き方が間違っていました」では、どのURLへ影響があるかが伝わりません。予想ALLOWと目的DISALLOWの二つを並べると、修正の必要性を具体的に示せます。
修正案は、グループごとの変更箇所として渡す
robots-good.txtでは、Googlebotのグループにも/search/の拒否、/search/help/の許可、/archive/*.pdf$の拒否を記載しています。先ほどの不足案から見れば、この三行を個別グループへ補う違いです。/preview-demo/の拒否は残します。一般向けグループの規則を削除して置き換える話ではありません。
# Fictional offline teaching file. Do not upload unchanged.
# Scope: https://atelier.example only; no real site is queried.
User-agent: *
Disallow: /search/
Allow: /search/help/
Disallow: /archive/*.pdf$

User-agent: Googlebot
Disallow: /search/
Allow: /search/help/
Disallow: /archive/*.pdf$
Disallow: /preview-demo/

Sitemap: https://atelier.example/sitemap.xml
上は通常案の必要な規則を含む全体です。差分を渡すときは、追加する三行だけを送らず、「Googlebotグループ内へ追加する」という位置も指定します。同じ行でも別グループへ置けば、対象が変わります。完成案全体と変更箇所の説明をセットにし、依頼元が元の内容と比べられる形にしてください。ここで示す差分も本番への追加指示ではなく、架空教材の比較です。
R21の見本ページは、不足案でも拒否されます。また、R22の説明ページも許可されます。この二つだけを試すと、「Googlebot用の変更は問題なさそう」と見えてしまいます。新しく足した条件だけでなく、それまで成立していた拒否を維持できているかを確認することが、グループ追加時の重要な観点です。
同じ名前のグループが分かれた場合を読む
ここからは主依頼とは切り離した構文演習です。robots-tie-and-merge.txtでは、同じGooglebotのグループを二つに分けています。一つ目に/same/と/notes/の拒否、二つ目に/same/と/notes/public/の許可があります。同じ具体的なユーザーエージェントに対応するグループは、Googleの解釈で統合して読まれます。
# Isolated exercise: two exact Googlebot groups merge.
User-agent: Googlebot
Disallow: /same/
Disallow: /notes/

User-agent: Googlebot
Allow: /same/
Allow: /notes/public/
R23の/same/は、同じ長さの許可と拒否に一致するためALLOWです。R24の/same/xでも結果は同じです。二つ目のグループを一つ目へ加えるという点だけに注目せず、統合した後に、該当URLへ一致する規則を比べるという二段階で読みます。
R25の/notes/xには拒否が一致し、R26の/notes/public/aにはより長い許可が一致します。R27の/Notes/xは大文字のNが違い、教材の拒否に一致しません。R28のSamplebotには、この演習ファイル内で該当するグループも*もなく、拒否なしの予想になります。いずれも主依頼の達成数へ加える例ではありません。
実務の読み合わせでは、先にグループへ色を付け、その後にURLが一致する行へ印を付けると、二つの判断を混ぜにくくなります。色を付けるために原本を編集せず、確認用コピーや別紙を使います。グループの選択を間違えたまま最長一致を正しく計算しても、対象クローラーの結果にはなりません。
Googleには用途の異なるクローラーがあり、AdsBotなどには別の注意もあります。ここで扱ったGooglebotと架空Samplebotの関係を、すべてのbotや派生名へ広げないでください。実案件で対象が増えたら、正式なユーザーエージェント名とその仕様を調べ、確認範囲を決め直します。教材には、その一般化を実証するテストはありません。
架空URLの判定表で変更案の不足を見つける
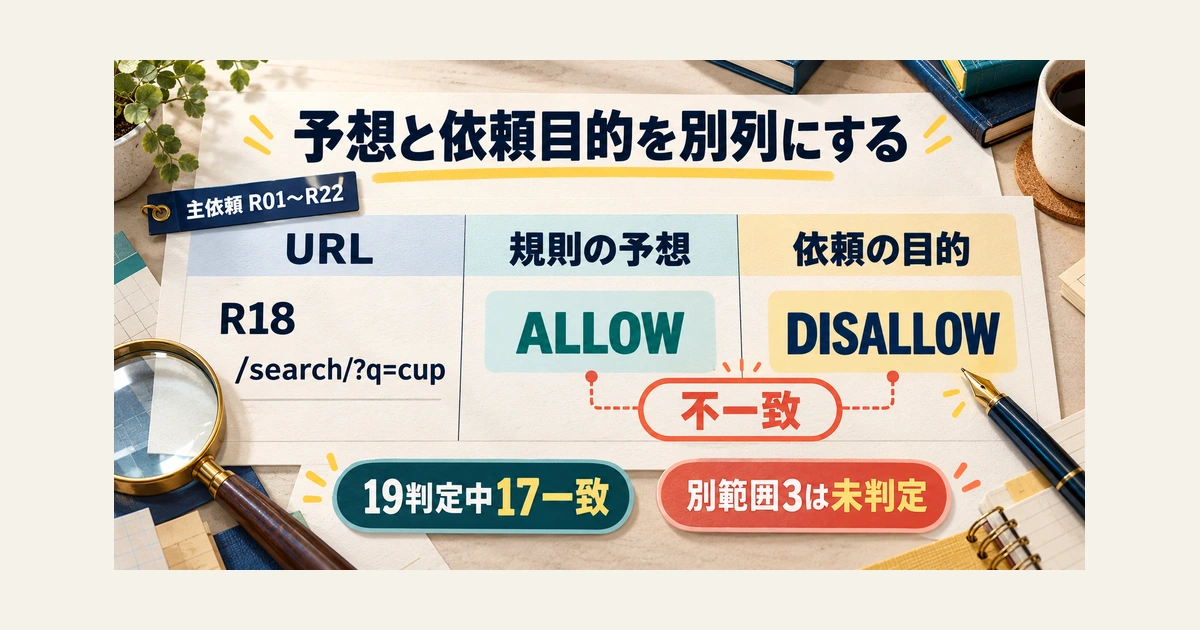
規則の予想と依頼の目的を別列にすると、不足案の不一致が見つかります。
規則の予想と、依頼が望む結果を別の列にする
変更案の確認では、「規則を読んだらどうなるか」と「依頼元はどうしたいか」を別の列にします。先に依頼の希望を見て結果を書き写すと、設定の不足を見逃します。まず対象範囲、対象グループ、一致する規則を順番に読み、予想を埋めてから依頼メモと照合するのが、この教材の進め方です。
下の表は、元32例から選んだ主依頼の代表12件です。URL欄は対象ホストを省いたパス表記ですが、R01〜R14、R18〜R22の実入力はhttps://atelier.exampleを付けた完全URLです。botはこの表の全行でGooglebot、通常案はrobots-good.txt、不足案はrobots-missing-group-rules.txtを指します。
※表は横にスクロールできます。
| 例 | 案 | URLのパス部分 | 規則の予想 | 主依頼の目的 |
|---|---|---|---|---|
| R02 | 通常 | /works/cup/ | ALLOW | ALLOW |
| R03 | 通常 | /assets/site.css | ALLOW | ALLOW |
| R04 | 通常 | /search/?q=cup | DISALLOW | DISALLOW |
| R05 | 通常 | /search/help/index.html | ALLOW | ALLOW |
| R06 | 通常 | /search/helper/ | DISALLOW | DISALLOW |
| R07 | 通常 | /search | ALLOW | ALLOW |
※表は横にスクロールできます。
| 例 | 案 | URLのパス部分 | 規則の予想 | 主依頼の目的 |
|---|---|---|---|---|
| R08 | 通常 | /Search/ | ALLOW | ALLOW |
| R09 | 通常 | /archive/guide.pdf | DISALLOW | DISALLOW |
| R11 | 通常 | /archive/guide.pdf?download=1 | ALLOW | ALLOW |
| R13 | 通常 | /preview-demo/page/ | DISALLOW | DISALLOW |
| R18 | 不足 | /search/?q=cup | ALLOW | DISALLOW |
| R20 | 不足 | /archive/guide.pdf | ALLOW | DISALLOW |
表の最後の二行が、変更案を返すときに説明すべき不一致です。予想のALLOWは読み間違いではなく、不足案に必要な規則がないことを表しています。「期待値どおりに動く」だけを合格条件にすると、この二行も成功に見えてしまいます。期待値を規則の予想として置いたのか、業務上の目的として置いたのかを、列名で明示しましょう。
元32例のうち、主依頼の確認はR01〜R22です。許可・拒否を評価できる19件では17件が目的と一致し、R18とR20の2件が不一致です。R15〜R17は別範囲なので未判定の3件として残します。17/19という数字を、同じ通常案だけを19件試した成績として説明しないことも大切です。比較のため、不足案の例を含んでいます。
残りの例で、対象の抜けを点検する
主依頼の残り10件も、次の二表に示します。GBはGooglebot、SBは架空Samplebotです。パスのみの欄は前の表と同じHTTPSの対象ホストを使い、別範囲の三行だけは完全URLで記載します。読み合わせでは、省略表記を完全URLへ戻すときに、この対応を確認してください。
※表は横にスクロールできます。
| 例 | 案・bot | URLのパス部分 | 規則の予想 | 主依頼の目的 |
|---|---|---|---|---|
| R01 | 通常・GB | / | ALLOW | ALLOW |
| R10 | 通常・GB | /archive/guide.PDF | ALLOW | ALLOW |
| R12 | 通常・GB | /archive/guide.pdf/extra | ALLOW | ALLOW |
| R14 | 通常・SB | /preview-demo/page/ | ALLOW | ALLOW |
| R19 | 不足・SB | /search/?q=cup | DISALLOW | DISALLOW |
※表は横にスクロールできます。
| 例 | 案・bot | URLまたはパス部分 | 規則の予想 | 主依頼の目的 |
|---|---|---|---|---|
| R15 | 通常・GB | http://atelier.example/search/ | OUT_OF_SCOPE | 未判定 |
| R16 | 通常・GB | https://shop.atelier.example/search/ | OUT_OF_SCOPE | 未判定 |
| R17 | 通常・GB | https://atelier.example:8443/search/ | OUT_OF_SCOPE | 未判定 |
| R21 | 不足・GB | /preview-demo/page/ | DISALLOW | DISALLOW |
| R22 | 不足・GB | /search/help/index.html | ALLOW | ALLOW |
代表例で規則の読み方を理解したら、補完表では取りこぼしを探します。同じパスを異なるbotで読む例と、別の範囲へ移った例は、確認している条件が違います。「似た行だから省略」と処理すると、グループと適用範囲の抜けが残ります。案件の目的から残す理由がある行を選ぶことが、確認表を使える資料にします。
全拒否と空欄は、独立した構文演習として扱う
R23〜R32の10件は、同名グループの統合、競合、全拒否、空欄を読む独立構文演習です。主依頼の目的はすべて適用外とし、観察結果を別に記録します。とくにR29〜R31は、作品ページやCSSまで拒否される危険を確認する例であり、主依頼がうまくいった件数へ加算するのは0件です。
独立演習の全10件は次のとおりです。対象ホストはhttps://atelier.example、GBとSBの意味は前表と同じです。表中の予想は演習で観察する結果であり、主依頼の目的を示しません。前半は同名グループの統合用ファイル、後半は全拒否と空欄のファイルを読みます。
※表は横にスクロールできます。
| 例 | bot | URLのパス部分 | 規則の予想・観察結果 | 主依頼目的 |
|---|---|---|---|---|
| R23 | GB | /same/ | ALLOW | 適用外 |
| R24 | GB | /same/x | ALLOW | 適用外 |
| R25 | GB | /notes/x | DISALLOW | 適用外 |
| R26 | GB | /notes/public/a | ALLOW | 適用外 |
| R27 | GB | /Notes/x | ALLOW | 適用外 |
| R28 | SB | /notes/x | ALLOW | 適用外 |
※表は横にスクロールできます。
| 例 | ファイル・bot | URLのパス部分 | 規則の予想・観察結果 | 主依頼目的 |
|---|---|---|---|---|
| R29 | all-block-warning・GB | / | DISALLOW | 適用外 |
| R30 | all-block-warning・GB | /works/cup/ | DISALLOW | 適用外 |
| R31 | all-block-warning・GB | /assets/site.css | DISALLOW | 適用外 |
| R32 | empty-disallow・GB | /works/cup/ | ALLOW | 適用外 |
全拒否のファイルは、User-agent: *に対してDisallow: /だけを指定した教材です。/は下位のパスにも一致するため、作品やCSSも拒否の予想になります。検索からの即時削除や認証保護を試した結果ではありません。公開サイトへそのままコピーして試す使い方は避けてください。
# Deliberately dangerous if copied to a public site. Offline exercise only.
User-agent: *
Disallow: /
空欄のDisallowは、この/と違います。robots-empty-disallow.txtのR32では、拒否するパスが指定されていないためALLOWです。末尾の一文字を見落とすと、読みが逆になります。空欄に見えたものを気軽に「補完」せず、原本を確認し、何のために置かれた行なのかを依頼元へ聞きます。
# Empty disallow is not the same as slash. Offline exercise only.
User-agent: *
Disallow:
固定32例の再現が示すことと、示さないことを記録する
制作時の独自モデルでは、固定期待値との一致は32/32でした。これは固定された教材を再現できたという机上確認で、本番の安全合格ではありません。主依頼への適合17/19、別範囲3件の未判定、独立演習10件の非加算は、その結果と同時に残ります。数字を一つへまとめないことで、不足案を発見した事実が消えません。
モデルが受理するのは、元32件にある「robotsのテキスト、bot名、URL文字列」の固定した組合せだけです。各要素が個別に既知でも、組合せが違えば判定しません。入力ガードは正規化をせず、未知の入力をUNSUPPORTEDとして拒否します。cases.jsonや五つのrobotsファイルが変わった場合も、未検証の変更として実行を止める設計です。
たとえば、見慣れたhttps://atelier.example/search/も、元の固定32組にないため未対応です。標準443を明示したURL、大文字host、空パス、パーセントエンコード、fragmentを含むURLも、このモデルへ追加して結果だけを信頼することはできません。未対応は許可でも拒否でもなく、追加の確認が必要な状態として読みます。
この制約は、テスト結果を増やすためにガードを外してよいという案内ではありません。新しい入力を調べたい場合は、まず仕様から期待値を決め、その入力を扱える実装と検証範囲を別途レビューする必要があります。教材用の成功結果を残したまま中身だけ差し替えると、どの版に対する確認か分からなくなります。
未検証なのは、Google公式パーサー、実際のGooglebot、HTTP応答、robotsの探索、キャッシュ、Unicodeとパーセントエンコード、URL正規化、bot派生の継承、検索表示、順位です。Googleには公式ライブラリもありますが、今回は実行していません。公式ライブラリを別途使う場合も、入力の前処理やクローラー外側の挙動まで何を扱うかを確認してください。Googleのrobotstxtライブラリ
判定表は、同じ入力を別の人が読み直せることにも価値があります。確認者には「不一致はあるか」だけでなく、「対象範囲を取り違えていないか」「許可を残すURLを落としていないか」「未判定を成功へ数えていないか」を見てもらいます。手元の結果がそろった段階で、承認を得るための材料ができたと考えましょう。
承認を得て変更案を渡し、設置後の確認を分担する
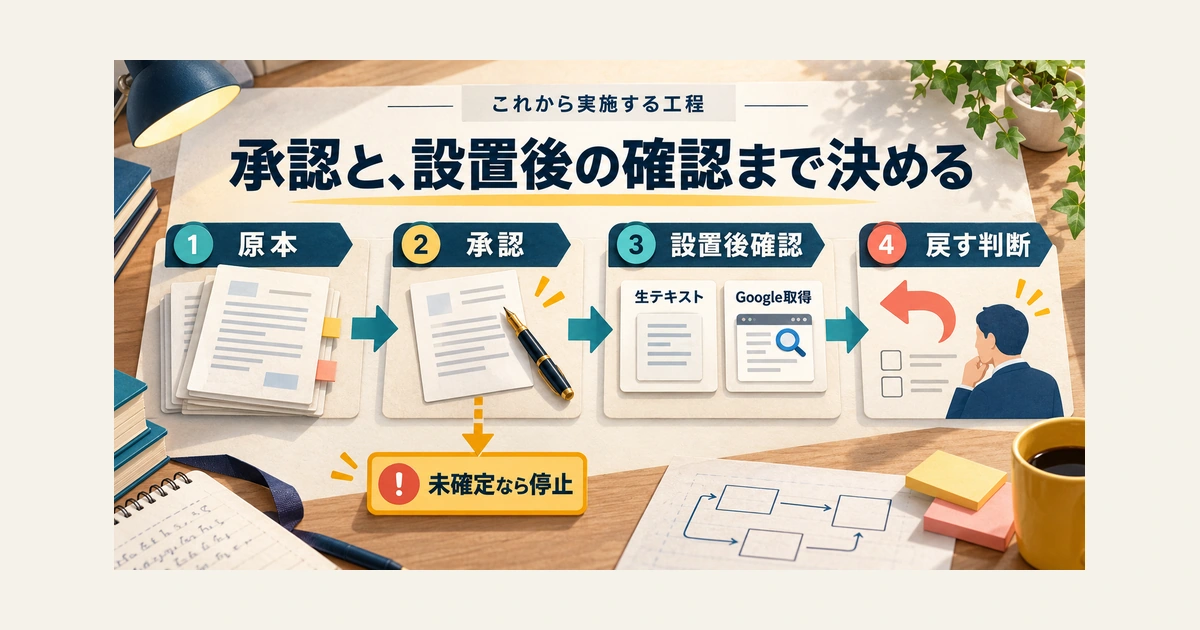
承認から設置後の確認、戻す判断までを実施前に分担します。
依頼元が判断できる単位で変更案を返す
依頼元へ渡す資料には、規則案だけでなく、目的、対象、差分、代表URLの予想、未確認を含めます。今回なら「Googlebotにも検索結果と末尾.pdfの拒否を適用し、説明ページの例外を維持する」という変更理由になります。不足案の二つの不一致を先に示せば、何を直そうとしているかが伝わります。
提出時には、ファイル名がgoodだから合格という扱いにしません。「教材上の通常案」「Googlebot規則が不足した比較案」という役割で読み、対象サイトへ採用できるかは依頼元が実際の目的と照合します。制作者の命名やローカルの成功表示が、本番反映への承認を代わりに出すことはありません。
確認依頼の架空例:対象はHTTPSのatelier.exampleです。Googlebot用グループへ検索・PDFの拒否と説明ページの許可を補う案を作りました。作品とCSSの許可を維持します。検索結果からの削除、顧客資料の保護、別ホストの変更は含みません。対象と目的をご確認いただき、設置担当と実施日時をご指定ください。
ここでの「対象と目的の承認」と、作業を実施するための権限は、両方を確認します。依頼をくれた人がサイトの管理責任者なのか、別部署の承認が必要なのかも案件によって違います。返事が「良さそうです」だけなら、具体的な変更範囲と実施担当が決まっているかを見直し、不明なまま反映しません。
確認票に、空欄のまま残してはいけない項目を作る
確認票は、後から作業経緯をたどれる程度の簡潔さで構いません。次はこの教材で埋められる範囲の見本です。承認日時や実施日時は、架空の成功記録を作らず未定のまま示しています。実案件では本人の返答や担当の実施記録を受けて更新します。
※表は横にスクロールできます。
| 項目 | この教材での記録 |
|---|---|
| 対象と目的 | HTTPSのatelier.exampleで、指定範囲の取得を抑える |
| 変更案 | 不足したGooglebotグループへ3行を補う案 |
| 維持するもの | 作品・CSS・説明ページの許可、一般向けの規則 |
| 承認者・承認日時 | 未確定。本番反映は保留 |
| 設置・復元担当 | 未確定。権限と戻す手順を確認する |
| 検証の残件 | 実HTTP・Google取得・検索表示は未検証 |
原本の保存先と、変更案の版も確認票へ書きます。承認後に案を直した場合は、どの変更なら承認範囲内かを判断できるよう差分を残してください。拒否対象やクローラー、設置先が変わる修正は、同じファイル名でも影響が変わります。以前の承認を新しい範囲へそのまま広げないようにします。
実施できる時刻には、変更後を確認する人と、問題時に戻せる人が対応できるかも含めます。設定を保存する数分だけを予定して、確認担当が不在のまま終えると、不具合の判断が次の日へ持ち越されます。期限が迫っていても、担当と戻す条件が決まっていない作業を、先に実行して埋め合わせることは避けます。
設置先の本文と、Google側の取得を分けて確認する
本番反映は、承認された担当が管理元の手順に従って行います。反映後は、対象のrobots.txtを改めて読み、HTTP状態と生テキスト、取得日時を記録します。ローカルの変更案と一致するか、想定外の行が増減していないかを比べます。保存ボタンの成功表示だけでは、配信された内容の一致までは確認できません。
次に、Googleがどの版を取得したかを別工程で確認します。Search Consoleのrobots.txtレポートでは、Googleが取得したファイルや取得日、警告・エラーを確認できます。権限のある担当者を決め、ローカルの確認結果と混ぜずに記録しましょう。Search Consoleのrobots.txtレポート
再取得を依頼できる場合も、依頼を受け付けた時刻と、実際に新しい内容が取得された時刻は別です。キャッシュや取得状況の影響があるため、すぐに切り替わるとは保証しません。「今すぐ変わらないから行を追加する」といった再編集を重ねず、どの版がどの時点で確認できたかを追います。
検索結果の表示は、さらに別の観測です。取得可能になったURLがいつ載るか、拒否したURLが表示から消えるかを、robots.txtの配信確認だけで判定しません。最初に相談された目的が検索表示なら、担当する制御方法と確認手順へ戻ります。順位が動いたことも、この変更だけの効果と短絡的に結び付けないようにします。
戻す条件を決め、確認待ちを引き継ぐ
戻す条件には、作品やCSSを予定外に拒否した、対象と違うホストの出力が変わった、承認した案と配信本文が一致しない、といった観測できる事象を挙げます。単に「何か変だったら」では、誰が判断するかが曖昧です。連絡先、判断者、復元する版、操作担当まで一緒に決めておきます。
問題が見つかっても、古い控えへ機械的に戻せばよいとは限りません。承認後に別の担当が必要な変更を入れている場合、戻すことでその変更を失う可能性があります。現在の内容と変更履歴を確かめ、決めておいた担当へ連絡して復元の範囲を判断します。控えは、その判断を支える材料として使います。
完了報告には、「案と配信本文の一致」「Google側の取得状況」「検索表示の確認」を別々に書きます。Google側がまだなら、最後に確認した時刻と次に確認する担当を残します。待っているだけの項目を完了にせず、同じ確認を誰かが最初からやり直さなくて済む形で引き継ぎます。
実案件で提出する一式は、目的と対象範囲のメモ、原本と差分付きの変更案、目的との不一致が分かるURL判定表、承認・設置後確認・復元の確認票です。これらがそろえば、規則の書き方を覚えた先の「この変更を進めてよいか」という相談に、根拠を持って参加できます。
robots.txtを扱う保守では、短い記述ほど広く効く可能性があります。依頼の意味を確認し、許可を守るURLも並べ、説明できない結果は止めて調べる。この順番を習慣にすると、作業量の小ささだけで引き受けることなく、変更前に必要な判断をそろえられます。